4 Adattisztítási eljárások
4.1 A hibákról
Fontos, hogy a kérdőívünket eleve úgy szerkesszük meg, hogy minimalizáljuk a hibákat. Például ha életkort várunk egy mezőben, akkor állítsuk be a kérdőívplatformon, hogy csak megfelelő tartományú számértéket lehessen rögzíteni, máskülönben nagyon vegyes minőségű válaszokat kaphatunk (pl. ‘1994’, ‘28 éves’, ‘44’), amit aztán egyesével, kézzel javítani kell. Hibákat márpedig javítani kell.
FONTOS: A hiányzó válasz nem hiba, NE töröljük ezeket az adatsorokat. Kizárólag a befejezetlen válaszokat zárjuk ki. Vannak olyan platformok, amelyek ezeket eleve nem is rögzítik, míg más platformok adatbejegyzéseket hoznak létre minden kitöltés megkezdésekor.
A fejezetben nem tárgyaljuk az adatok kérdőívplatformról való letöltését, Excelben előkészítését, egyértelmű hibák javításának menetét Excelben. Az ilyen irányú egyéni számítástechnikai ismeretek felfrissítésére javaslom a Stathelp vonatkozó YouTube videóinak megtekintését: 1, 2, 3.
4.2 Az outlierek, a szélsőséges vagy extrém értékek azonosítása
Egy kiugró vagy nem tipikus válasz önmagában még nem hibás mérési eredmény, hanem olyan adatpont, amely a mért pontok többségétől jelentősen távolabb esik. Ennek következménye, hogy jelenléte miatt jelentősen alul- vagy túlbecsülhetjük a hagyományos statisztikai mutatókat (pl. átlag, szórás).
Ha kutatási tervünk alapján egy kérdőívet 18 és 39 év közötti személyekkel kell kitöltetnünk, de az egyik válaszunk (mért értékünk) 57 év, akkor az egyértelműen hiba, a válasznak mennie kell. Természetesen erről is írunk a szakcikkben, szakdolgozatban, hogy x db hibás választ (okkal megjelölve) töröltünk.
Azonban ha a kutatási tervünkben 18 és 65 év közötti személyeket terveztünk vizsgálni, de egy 57 éves válaszadó híján mindenki 18 és 39 év közötti, akkor valószínűleg szélsőséges értékről beszélünk.
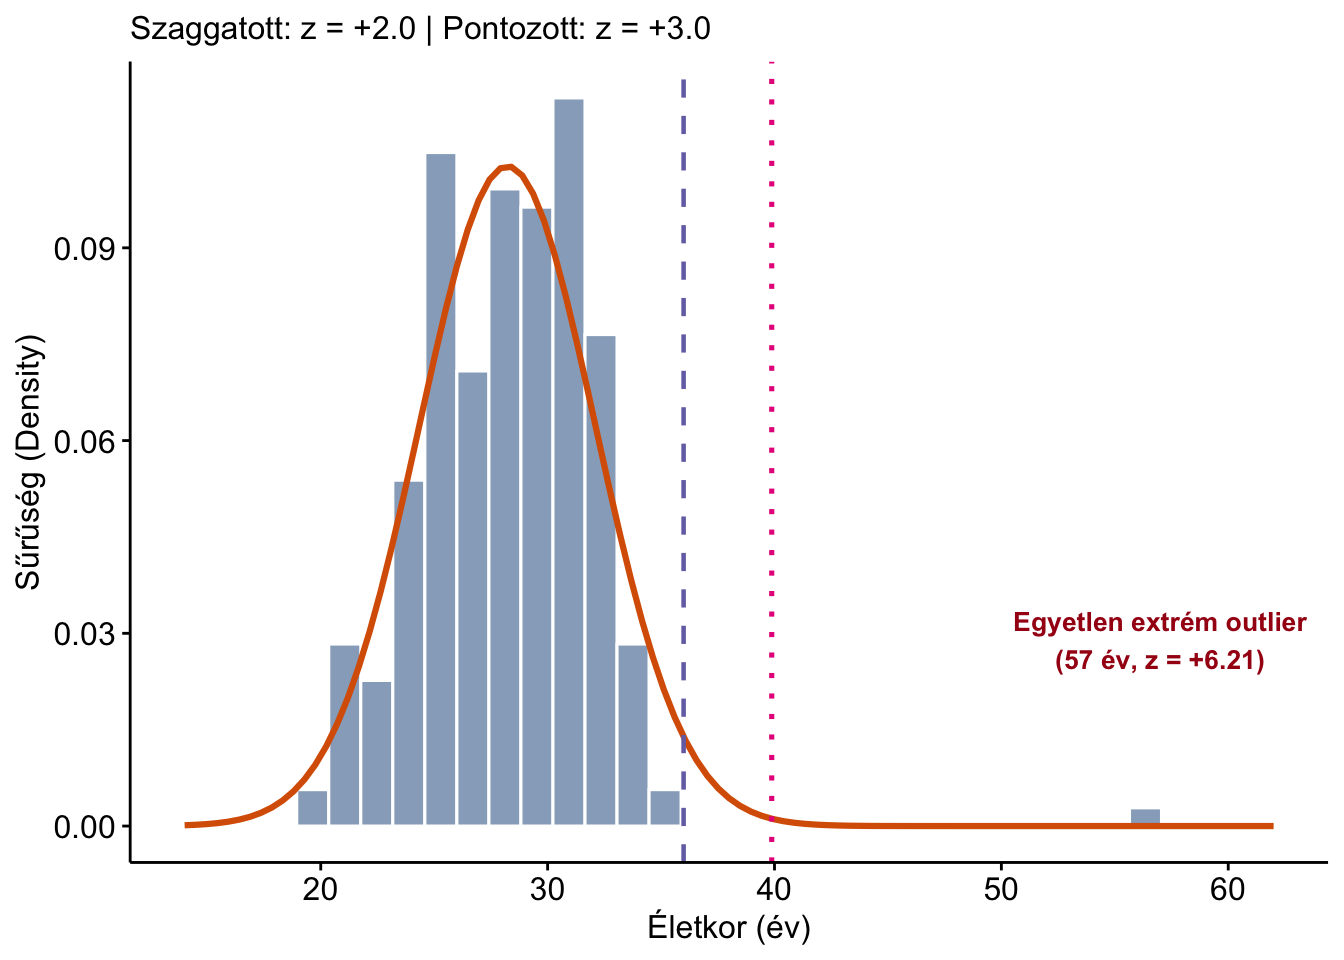
Ezen adatpontokat leggyakrabban a Z-értékek alapján, vagy a kvartilisek mérete alapján azonosítjuk. Nézzük meg, hogy a fenti példában hogyan nézne ez ki egy fiktív adatsoron.
Normál eloszlású vagy annak várt eloszlások esetén a Z-érték alapú meghatározás megfelelő lehet. Ez esetben a 3,0 fölötti vagy -3,0 alatti Z-értékű adatokat jelöljük szélsőséges értéknek. Alapvető gyengesége, hogy maga a Z-transzformáció az átlagra és a szórásra épül, amelyeket az extrém értékek már eleve torzítanak, ezért inkább ne alkalmazzuk (Leys és mtsai., 2013).
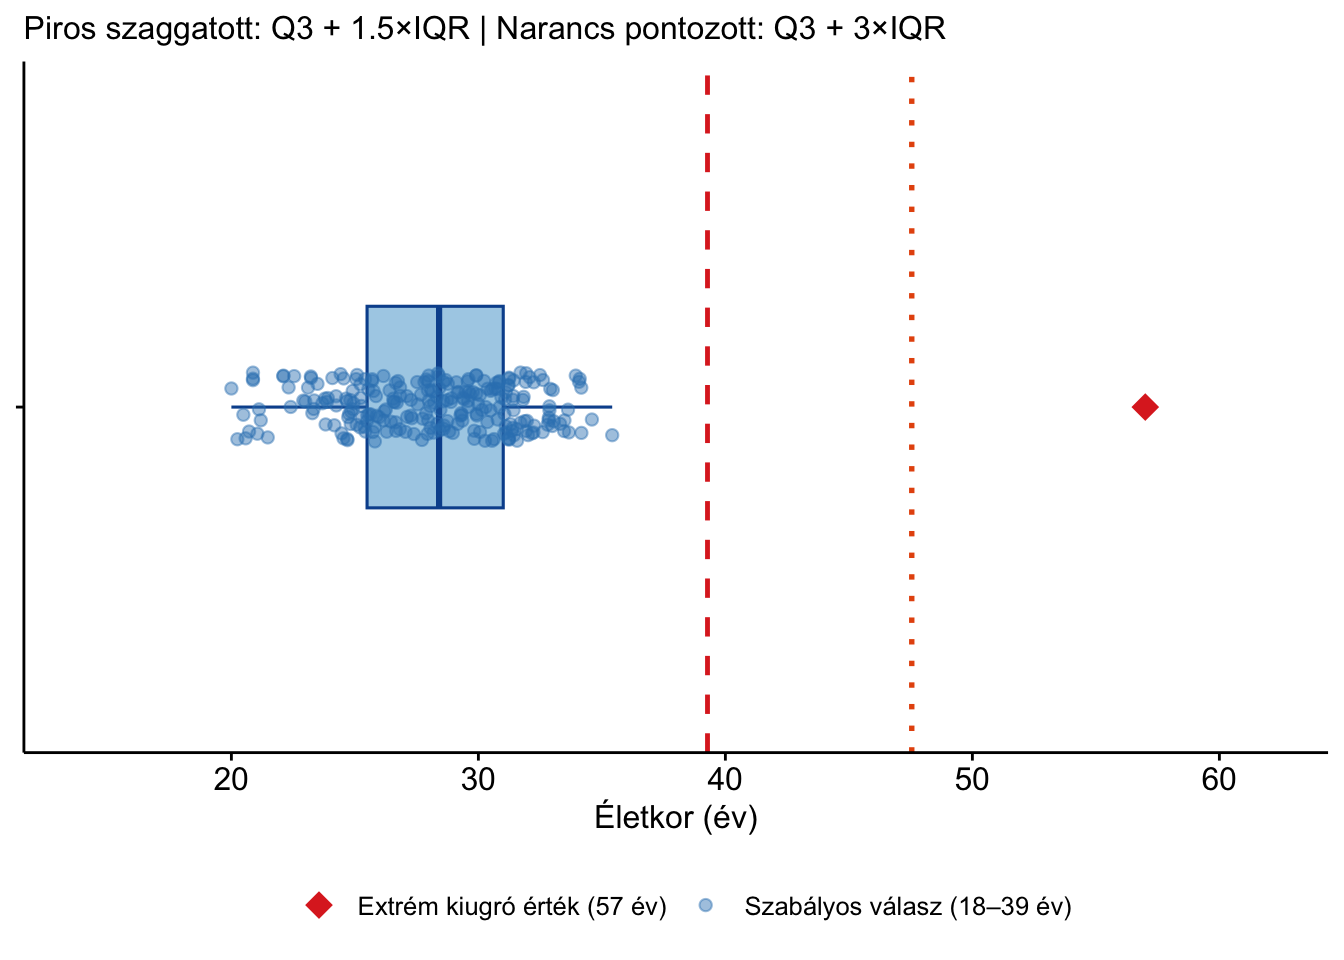
Ehelyett javasolt az IQR-alapú Tukey-féle módszer (Tukey, 1977). Az IQR alapú azonosítás mind a normál eloszlású, mind az erősen ferde eloszlások vizsgálatához megfelelő (ahogy egy nemparametrikus eljárás), így ez utóbbit javaslom alkalmazásra. Az IQR alapú módszer szigorú határa 1,5×IQR, tehát már alacsonyabb szélső értékeket is megjelöli (ún. belső határ, inner fence, outlier). Az enyhébb, megengedő határ a 3×IQR, ami viszont már extrém értékeket jelöl inkább (ún. külső határ, outer fence, far out value). A JASP boxplot ábrája a 1,5-es szabály szerint ábrázolja a szélsőséges értékeket.
\[ \text{Felső szélsőértékek határa} = \text{Q3} + 1{,}5 \times \text{IQR} \\ \text{Alsó értékek határa} = \text{Q1} - 1{,}5 \times \text{IQR} \\ \]
4.3 Az outlierek, a szélsőséges vagy extrém értékek kezelése
Döntenünk kell a szélsőséges érték kezelési módjáról. Leginkább három lehetőségünk van:
Esetkizárás, csonkítás, vagyis trimming: a legegyszerűbb módszer az, hogy egyszerűen teljes válaszokat kizárunk. Ezt lehet egy-egy adatpont esetén, vagy választhatjuk, hogy az adatok alsó és felső 10-10%-át töröljük. Ez a módszer erősen torzítja a varianciát, jelentős információveszteséggel jár, a mintaelemszámunk is csökken. Ez a gyakorlatban már ritka, és különösen indokolt esetben fogadják el a peer review-erek.
Winsorizálás (winsorization): A szélsőséges értékeket nem töröljük, hanem az értéküket változtatjuk meg, mégpedig úgy, hogy közelebb hozzuk a legutolsó vagy legelső nem szélsőséges értékhez. Egyik megközelítés alapján az 1. és a 99. percentilisnek megfelelő értékére írjuk át a szélsőséges értékeket. Más tankönyvírók megközelítése szerint a legnagyobb még nem szélsőértéknél 1 egységgel nagyobb értékre írjuk át a felső szélsőséges értékeket, vagy a legkisebb még nem szélsőértéknél 1 egységgel kisebb értékre írjuk át az alsó szélsőséges értékeket (Tabachnick és Fidell, 2019). Ez egy teljesen önkényes eljárás. Winsorizáláshoz a percentilis alapú megközelítést javaslom.
Matematikai adattranszformáció: Léteznek nemlineáris matematikai adattranszformációs módszerek (pl. logaritmusalapú, négyzetgyökvonásos, Box–Cox transzformáció) (Box és Cox, 1964). A nemlineáris transzformációk a jobbra ferde eloszlások esetén a nagy értékeket arányaiban jobban „összenyomják”, mint a kicsiket, ezáltal a kiugró értékek közelebb kerülnek az eloszlás centrumához, miközben egyetlen adatpontot sem veszítünk. Jelentős hátránya az, hogy a kapott értékeket nehézkes értelmezni, elveszítik a gyakorlati jelentésüket, és a visszatranszformálásuk sem oldja meg minden paraméter torzítatlan értelmezését (Feng és mtsai., 2014).
Robusztus statisztikai eljárások: ha az eloszlást és az azt összetevő mért értékeket nem szeretnék se kizárni, se manipulálni, használjunk robusztus statisztikai eljárásokat, amelyek matematikai tulajdonságaik alapján ellenállóak a szélsőértékekkel szemben (Wilcox és Keselman, 2003). Egyéni javaslatom ez utóbbi eljárások alkalmazása.
4.4 Hiányzó értékek kezelése
Minden kérdőívben előfordulnak kérdések, amikre nem kapunk választ. Erre nem az a megoldás, hogy választ kötelezővé teszünk. Ez jelentős kutatásetikai vétség! A hiányzó értékeket tudjuk kezelni statisztikailag.
Ha csak kevés hiányzó értékkel találkozunk (< 5%), az esetek szerinti kizárás (listwise deletion) is alkalmazható. Nagyszámú hiányzó válasz esetén ez szintén torzító. Egyes statisztikai eljárásoknál páronkénti törlés is kezdeményezhető (pairwise deletion). A szoftver csak az adott két változó közötti elemzésből (pl. korreláció) hagyja ki a hiányos eseteket. Bár látszólag megőrzi a minta elemszámát, súlyos módszertani hátrányai is vannak.
Korábban alkalmazták a hiányzó értékek pótlását átlaggal vagy mediánnal, de ez mesterségesen csökkenti a szórásnégyzetet, így ezt a megoldást nem javasoljuk.
Az egyes statisztikai próbáknál tárgyaljuk a hiányzó értékek kezelésének odaillő módját.