flowchart LR

    subgraph teljeshatas ["Teljes hatás"]
    direction LR

    X["Prediktorváltozó (X)"]
    Y["Eredményváltozó (Y)"]

    X -- c --> Y

    end

    style X fill:#ffffff,stroke:#333333,stroke-width:2px
    style Y fill:#ffffff,stroke:#333333,stroke-width:2px
    style teljeshatas fill:none,stroke:none
8 Mediáció és moderáció
A többváltozós lineáris regresszió során azt feltételeztük, hogy minden prediktor változó közvetlenül és együttesen, egymásra épülve hat az eredményváltozónkra. A pszichológiai konstruktumok ritkán ennyire egyszerűek. A pszichológiai jelenségek valószínűleg leginkább összetett, egymást erősítő-gyengítő mechanizmusok eredménye (hasonlóan az idegrendszeri komplex excitatórikus és gátló jelek összjátékához).
A mediáció arra a kérdésre adja meg a választ, hogy hogyan alakul ki egy összefüggés, egy hatás. A prediktorok és eredményváltozó között lehet közvetlen kapcsolat is, de mellette van egy közvetítő is közbeékelve. Azt feltételezzük, hogy időbelileg a prediktor változónkat követi a mediátorváltozó, amit követ az eredményváltozó.
A moderáció ezzel szemben arra keresi a választ, hogy mikor, kiknél vagy milyen feltételek együttállása esetén és milyen mértékben érvényes az oksági kapcsolat.
8.1 Mediáció
Egy egyszerű mediációs modellben a prediktorváltozó (X) és az eredményváltozó (Y) közötti teljes hatást két összetevőre bontjuk:
közvetett hatás (indirect effect, \(ab\)): az a hatás, amelyik a prediktor változóból (X) a mediátorváltozón (M) keresztül jut el az eredményváltozóig (Y)
közvetlen hatás (direct effect, \(c'\)): a prediktorváltozó (X) azon hatása az eredményváltozóra (Y), amelyik a mediátorváltozótól (M) teljesen független
flowchart LR

    subgraph Konceptualis ["Mediációs útdiagram"]
        direction LR
        M["Mediátor (M)"]
        X["Prediktorváltozó (X)"]
        Y["Eredményváltozó (Y)"]

        X e1@-- a --> M
        M e2@-- b --> Y
        X -- c' --> Y
    end

    e1@{ animate: true, animation: fast }
    e2@{ animate: true, animation: fast }

    style X fill:#ffffff,stroke:#333333,stroke-width:2px
    style M fill:#eef6fa,stroke:#1d6f8a,stroke-width:2px
    style Y fill:#ffffff,stroke:#333333,stroke-width:2px
    style Konceptualis fill:none,stroke:none
Nézzük az egyenleteket:
\[ \text{Teljes hatás (c):} \\ c = \text{közvetlen hatás} + \text{közvetett hatás}= c' + a \times b \\ \text{Közvetett hatás:} \\ a \times b = \text{teljes hatás} - \text{közvetlen hatás}= c - c' \]
A fenti egyszerű modell elemzése lineáris regressziószámítással az alábbiak szerint történik:
Az a út egy egyszerű lineáris regresszió ahol a prediktorváltozó marad az eredeti X, a kimeneti változó pedig a mediátor (M)
A b és c’ út kiszámítása többszörös lineáris regresszióval történik, ahol mind a mediátor (M), mind az eredeti prediktorváltozó (X) prediktorként szerepel, a kimeneti változó pedig a végső eredményváltozónk (Y).
Az a, b és c’ utakhoz tartozó értékeket a koefficiens táblákból olvassuk le.
Kézi számítás esetén ajánlott a nem standardizált regressziós együtthatókat (Unstandardized) használni, mivel az indirekt hatás szorzata ebben a formában őrzi meg az eredeti mérési skála közvetlen értelmezhetőségét és torzítatlanságát.
Ha standardizált hatásnagyságra van szükségünk, a különálló regressziók standardizált bétáinak összeszorzása helyett használjuk inkább a JASP Mediation modulját (Standardized estimates opció: All). Itt mind a direkt, mind az indirekt hatások láthatóak, és nem szükséges manuális szorzatokat számolnunk, közvetlenül a teljesen standardizált indirekt hatást számítja ki, megadja a bootstrap konfidenciaintervallumot, és feleslegessé teszi a manuális szorzást.
A fentiek miatt a gyakorlatban eleve a Mediation modul használatát javaslom.
8.1.1 Baron és Kenny (1986) modellje
Baron és Kenny (1986) négy lépésben igazolja a mediációt:
A prediktorváltozó statisztikailag szignifikánsan bejósolja az eredményváltozót: \(c \ne 0\)
A prediktorváltozó statisztikailag szignifikánsan bejósolja a mediátorváltozót: \(a \ne 0\)
A mediátorváltozó statisztikailag szignifikánsan bejósolja az eredményváltozót, miközben kontrollálunk a prediktorváltozóra: \(b \ne 0\)
Ha a mediátorváltozót bevonjuk a modellbe, a prediktorváltozó abszolút hatása az eredményváltozóra lecsökken (\(|c'| < |c|\)), vagy nem szignifikánssá válik (\(c' \approx 0\)).
Ennek a szemléletnek többféle kritikája van:
Alacsony statisztikai erő a lépésenkénti szignifikanciatesztek miatt, mert a másodfajú hiba (fals negatív) valószínűsége drasztikusan megnő.
Inkonzisztens mediáció, szupresszió esetén a közvetlen és közvetett hatások ellentétesek is lehetnek, kioltva ezáltal a teljes hatást, tehát a teljes hatás nem feltétlenül kellene szignifikáns legyen, miközben tényleges és teljes, valódi közvetítő mechanizmus van a háttérben (Zhao és mtsai., 2010).
A Sobel-próbával vizsgáljuk, hogy a mediátorváltozó szignifikánsan közvetíti-e a prediktorváltozó hatását az eredményváltozóra úgy, hogy az indirekt hatás szignifikánsan eltér a nullától. A próba eredménye egy z-érték, ahol az indirekt hatást elosztjuk annak standard hibájával: \(z = \frac{a \times b}{SE_{a \times b}}\). Viszont ez próba azt feltételezi, hogy az \(a \times b\) normál eloszlást követ, de mivel két normál eloszlású változó szorzata ferde és aszimmetrikus eloszlású, a Sobel-teszt nem megbízható kis és közepes mintákon (MacKinnon és mtsai., 2004).
8.1.2 A nemparametrikus bootstrapping
A modernebb megközelítés a korszerű ajánlások (Hayes és Little, 2022) alapján az, hogy a közvetett hatást közvetlenül teszteljük nemparaméteres bootstrapping eljárással:
Az eredeti \(N\) elemszámú mintából visszatevéssel generálunk \(B = 5000\) (de legalább 1000) db bootstrap mintát.
Minden mintában megbecsüljük az \(a_k\) és \(b_k\) együtthatókat és képzünk egy \((a \times b)_k\) szorzatot, ami a közvetett hatás.
Az 5000 db imént képzett közvetett hatást nagyság szerinti sorrendbe rendezzük (ti. empirikus eloszlás), meghatározzuk a 2,5-ik és 97,5-ik percentiliseket (percentilis módszerrel) és így megállapítjuk az adatok 95%-át lefedő konfidenciaintervallumot. Bár korábban elterjedt volt a torzításkorrigált (BCa) módszer, a modern szimulációs vizsgálatok (Hayes és Scharkow, 2013) alapján a hagyományos percentilis bootstrap megbízhatóbb, mivel a BCa kis és közepes mintáknál hajlamos az elsőfajú hibát torzítani.
DÖNTÉS: ha a 95%-os bootstrap konfidenciaintervallum nem tartalmazza a nullát, akkor a közvetett hatás (\(a \times b\)) statisztikailag szignifikáns (α = 0,05 szignifikanciaszint mellett).
8.1.3 Mediációs elemzés JASP-ban
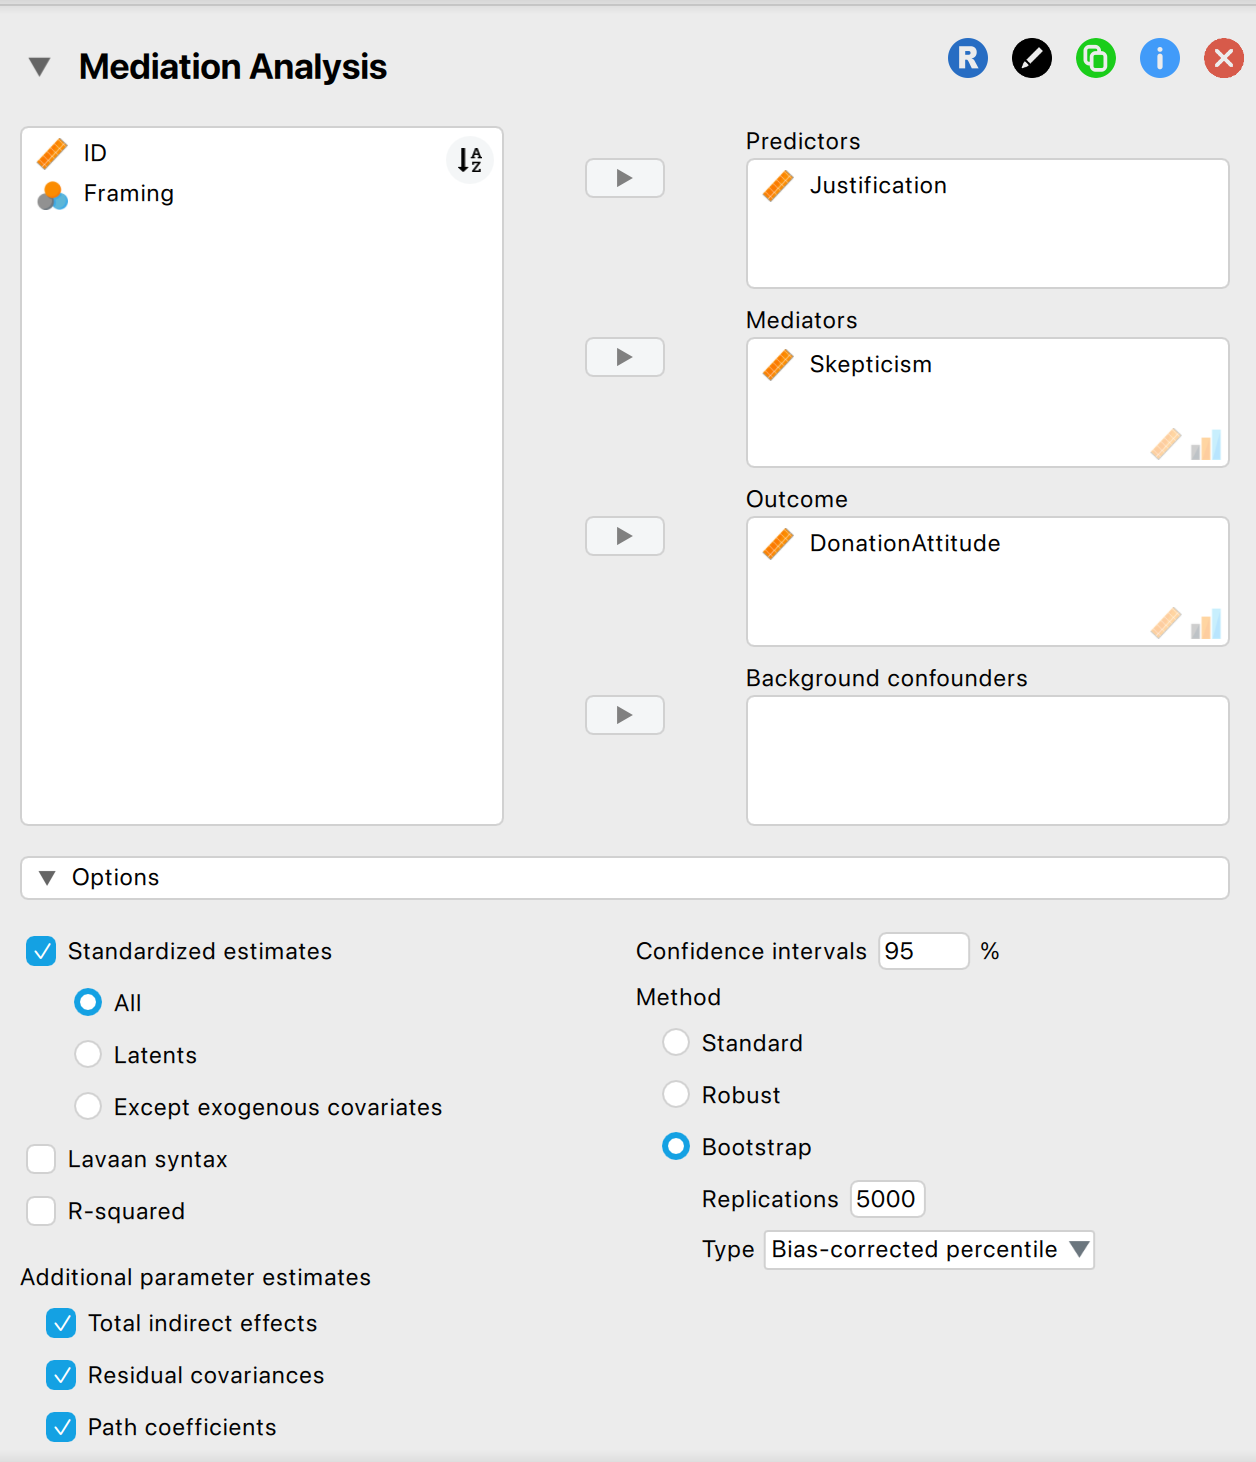
A mediációs modellek elemzését egyszerű mediációk esetén végezhetnénk egyváltozós és többváltozós lineáris regressziók manuális elvégzése alapján. R-ben és az R alapú JASP-ban a SEM modul Mediation almoduljában mind a hagyományos, mind a bootstrapping alapú megoldást választhatjuk manuális számítás nélkül, valamint a diagramot is le tudjuk gyártani. A kimenet megnevezi mind a direkt, mind az indirekt út értékeit, valamint az egyes változók közötti utak hatásnagyságait is.
Részletes, és gold standard útmutató érhető el Vargha (2023) kiváló cikkében mind az elmélet, mind a JASP-beli (és ROP-beli) alkalmazás kapcsán.
A Mediation modul felépítése:
Példa 8.1
Megoldás 8.1.
8.2 Moderációelemzés
A moderációban azt teszteljük, hogy X prediktorváltozónk prediktív (bejósló) ereje megváltozik-e a moderátorunk (W) különböző értékei mellett. (Hasonló elemzéseket látunk majd különbségvizsgálatok során a többváltozós ANOVA módszernél.)
flowchart LR
    subgraph Teormodel ["Elméleti modell"]
        direction LR
        %% Változók
        X["Prediktorváltozó (X)"]
        Y["Eredményváltozó (Y)"]
        W["Moderátor (W)"]

        %% Láthatatlan illesztési pont a vonalon
        mid(( ))

        %% Vonalak összekötése
        X --- mid
        mid --> Y
        W -.->|módosítja az összefüggést| mid

        end

        %% Vizuális formázás
        style Teormodel fill:none,stroke:none
        style mid width:0px,height:0px,stroke:none,fill:none
        style X fill:#ffffff,stroke:#333333,stroke-width:1.5px
        style Y fill:#ffffff,stroke:#333333,stroke-width:1.5px
        style W fill:#eef6fa,stroke:#1d6f8a,stroke-width:2px
flowchart LR
    subgraph Statmodell ["Statisztikai modell"]
        direction LR
        X["X (főhatás)"]
        W["W (főhatás)"]
        XW["X × W (interakció)"]

        X ~~~ W
        W ~~~ XW

        Y["Y (Kimenet)"]

        X -->|b₁| Y
        W -->|b₂| Y
        XW -->|b₃| Y

    end

    subgraph statmodelresid ["maradványértékek"]
        E(("e"))
        Y ~~~ E
        E --> Y
    end


    style Statmodell fill:none,stroke:none
    style statmodelresid fill:none,stroke:none
    style X fill:#ffffff,stroke:#333333,stroke-width:1.5px
    style W fill:#ffffff,stroke:#333333,stroke-width:1.5px
    style XW fill:#eef6fa,stroke:#1d6f8a,stroke-width:2px
    style Y fill:#eef6fa,stroke:#1d6f8a,stroke-width:2px
    style E fill:#ffffff,stroke:#555555,stroke-dasharray: 3 3,stroke-width:1.5px
A statisztikai modellben a regressziós alapegyenletünk:
\[ Y_i = b_0 + b_1X_i + b_2W_i+b_3(X_i \times W_i) + e_i \]
Átrendezve:
\[ Y_i = (b_0 + b_2W_i) + (b_1 + b_3W_i)X_i + e_i \]
ahol \((b_0 + b_2W_i)\) a feltételes tengelymetszet (conditional intercept), a \((b_1 + b_3W_i)\) az egyszerű/feltételes meredekség (simple slope / conditional slope), \(b_3\) pedig az interakciós együttható, ami azt mutatja meg, hogy a moderátor 1 egységnyi növekedésével mennyivel változik meg X regressziós súlya Y-ra.
8.2.1 Mean centering (változók átlagra történő központosítása)
Folytonos változók szorzatakor (itt: \(X \times W\)) az interakciós tag magától értetődően korrelálni fog a komponenseivel (X-szel és W-vel), ami ún. járulékos multikollinearitáshoz (non-essential multicollinearity) vezethet, ami megnehezíti az értelmezést.
A mean centering során egy változó minden egyes értékéből kivonjuk az átlagot:
\[ X_c = X - \bar{X} \\ W_c = W - \bar{W} \\ Y_i = b_0 + b_1X_{ci} + b_2W_{ci} + b_3(X_{ci} \times W_{ci}) + e_i \]
8.2.1.1 Miért szükséges a központosítás?
A pszichológiában például egy 1-től 5-ig terjedő Likert skálán nincs valódi 0 pont. Intelligenciateszten vagy szorongáskérdőíven sem létezik 0 összpontszám. Ha nem központosítunk, akkor a \(b_1\) azt mutatná, hogy mekkora X főhatás hatása egy olyan válaszadónál, akinél a moderátor (W) értéke pontosan 0; valamint \(b_0\) azt mutatná meg, hogy mennyi az eredményváltozó (Y) annál, akinél mind a prediktorváltozó, mind a moderátorváltozó értéke 0.
A mean centering előnyei:
A főhatások (\(b_1\) és \(b_2\)) önmagukban értelmezhetők. Központosítás után a 0 érték pontosan a minta átlagát jelenti. Így \(b_1\) azt fejezi ki, hogy mekkora a prediktorváltozó (X) hatása egy olyan személy esetében, aki átlagos szinttel rendelkezik a moderátorváltozón (W).
Értelmezhetővé válik a tengelymetszet (\(b_0\)) is. A tengelymetszet nem egy 0 pontos válaszadó becsült értéke lesz, hanem az eredményváltozó (Y) várható szintje egy minden szempontból átlagos (átlagos X és átlagos W) kitöltő esetében.
A központosítás kizárólag a skálák kiindulópontját tolja el, a kapcsolatok meredekségének változását nem érinti, tehát az interakció (\(b_3\)) változatlan marad.
8.2.2 Simple slopes (egyszerű meredekség) vizsgálata
Ha az interakciónk (\(b_3\)) szignifikáns, akkor fel kell tárnunk az összefüggést:
- Spotlight analízis
Kiszámítjuk a prediktorváltozónk (X) hatását a moderátorváltozónk (W) egyes pontjain:
alacsony szint: \(\bar{W}-1 \text{ SD}\)
moderátor átlaga: \(\bar{W}\)
magas szint: \(\bar{W}+1 \text{ SD}\)
- Floodlight analízis (Johnson-Neyman technika)
Nem önkényesen választunk pontokat, mint a spotlight analízis esetén, hanem a moderátor kritikus szintjeit választjuk ki (regions of significance), amelyek alatt/felett a prediktorváltozónk (X) eredményváltozóra (Y) tett hatása átlépi a p = 0,05-ös szignifikanciaszintet.
Példa 8.2
Megoldás 8.2.
8.3 A mediációval és moderációval kapcsolatos megfontolások
A mediáció- és a moderációelemzés önmagában nem ok-okozati összefüggést tár fel, főleg nem keresztmetszeti kutatásban.
Ha van olyan zavaró változó, amelyiknek szintén hatása van az eredményváltozónkra, de azt nem mértünk, akkor a becslésünk torzított, és valószínűleg magas maradványértékeink lesznek a modellben.
Ha az M mediátorváltozónk mérési hibákat tartalmaz (pl. alacsony reliabilitású kérdőív), akkor a b-t alulbecsüljük, míg a c’-t túlbecsüljük.