flowchart LR
    %% 1. Bal oldali oszlop: prediktorok vertikálisan
    subgraph BalOszlop [" "]
        direction TB
        X1["X₁ (1. prediktor)"]
        X2["X₂ (2. prediktor)"]
        X3["X₃ (3. prediktor)"]

        %% Prediktorok közötti korrelációk (vertikális kétfejű nyilak)
        X1 <-->|r₁₂| X2
        X2 <-->|r₂₃| X3
    end

    %% 2. Középső kimeneti változó
    Y["Y (Kimenet)"]

    %% 3. Jobb oldali hiba / reziduum
    E(("e"))

    %% Regressziós hatások a prediktoroktól a kimenetig
    X1 -->|β₁| Y
    X2 -->|β₂| Y
    X3 -->|β₃| Y

    %% Elrendezés-kényszerítés: E legyen Y-tól jobbra, és mutasson balra Y-ba
    Y ~~~ E
    E --> Y

    %% Formázási és stílusbeállítások
    style BalOszlop fill:none,stroke:none
    style Y fill:#eef6fa,stroke:#1d6f8a,stroke-width:2px
    style E fill:#ffffff,stroke:#555555,stroke-dasharray: 3 3,stroke-width:1.5px
    style X1 fill:#ffffff,stroke:#333333,stroke-width:1.5px
    style X2 fill:#ffffff,stroke:#333333,stroke-width:1.5px
    style X3 fill:#ffffff,stroke:#333333,stroke-width:1.5px
7 Többváltozós lineáris regresszió
Míg az egyszerű lineáris regresszióban egyetlen prediktor segítségével jósoltuk be az eredményváltozót, a valóságban a pszichológiai jelenségek soha nem vezethetők vissza csak egy tényezőre. Többváltozós lineáris regresszió esetén:
- Több prediktor együttes magyarázóerejét vizsgálhatjuk (korrigált \(R^2\) a populációra vonatkozó következtetéskor)
- A parciáliskorreláció-vizsgálatokhoz hasonlóan kovariánsokat és zavaró (confounding) tényezőket tudjuk kontrollálni. Vagyis egy változó tiszta, független hatását tudjuk izolálni és értelmezni.
- Hierarchikus modellfelépítés segítségével egymással versengő alternatív modelleket tudunk összehasonlítani.
Elméleti (populációs) regressziós modell:
\[Y_i = \beta_0 + \beta_1 X_{i1} + \beta_2 X_{i2} + \dots + \beta_p X_{ip} + \epsilon_i\]
A regressziós modell által becsült érték (\(\hat{Y}_i\)) képlete:
\[\hat{Y}_i = b_0 + b_1 X_{i1} + b_2 X_{i2} + \dots + b_p X_{ip}\]
A mért érték felbontása:
\[Y_i = \hat{Y}_i + e_i\]
Ahol:
- \(Y_i\): a függő változó (eredményváltozó) ténylegesen mért értéke az \(i\)-edik megfigyelésnél
- \(\hat{Y}_i\): a modell által becsült érték az \(i\)-edik megfigyelésnél
- \(\beta_0\): a populációbeli tengelymetszet (intercept)
- \(\beta_j\): a \(j\)-edik prediktorhoz tartozó populációbeli parciális regressziós együttható
- \(\epsilon_i\): a populációbeli véletlen hiba (hibatag) az \(i\)-edik megfigyelésnél
- \(b_0\): a mintabeli tengelymetszet (konstans, intercept); az eredményváltozó becsült értéke, amikor az összes prediktor értéke \(0\) (\(X_{i1} = X_{i2} = \dots = X_{ip} = 0\))
- \(b_j\): a \(j\)-edik prediktorhoz tartozó mintabeli parciális regressziós együttható (nem-sztenderdizált meredekség)
- \(p\): a modellben szereplő független (prediktor) változók száma
- \(e_i\): a modell maradványértéke (reziduum) az \(i\)-edik megfigyelésnél: \(e_i = Y_i - \hat{Y}_i\)
7.1 Hipotézisek a többváltozós lineáris regresszióban
A többváltozós regresszióban kétféle statisztikai hipotézistesztelést végzünk:
A modell globális illeszkedésére (Omnibus F-teszt)
\(H_0: R^2 = 0\), vagyis \(\beta_1 = \beta_2 = ... = \beta_p = 0\). Vagyis egyik prediktor se magyaráz szignifikáns varianciát a függő változóból.
\(H_1: R^2 > 0\), vagyis legalább egyik \(\beta_j \not= 0\). A modell egésze szignifikánsan jobban jósol, mint a puszta átlag (\(\bar{y}\)).
Az egyedi parciális koefficiensekre (t-tesztek minden egyes prediktorra)
\(H_0: \beta_j = 0\).
\(H_1: \beta_j \not= 0\). Adott \(j\) prediktor a többi prediktor hatásának rögzítése mellett is szignifikáns magyarázóerővel bír.
7.2 Modellépítési stratégiák
| Módszer | Működési elv | Mikor javasolt? | Korlátok és módszertani kockázatok |
|---|---|---|---|
|
Egyidejű (Enter) |
Minden kiválasztott prediktort egyszerre, egyetlen lépésben léptetjük be a modellbe. Minden koefficiens parciális hatást tükröz. | Feltáró kutatások esetén, ha nincs elméleti megalapozottsága más feltételezésnek, vagy tudvalevő, hogy a bevonandó prediktorok egyenrangúak. | Nem mutatja meg a prediktorok hierarchikus, blokkonkénti járulékos magyarázóerejét (\(\Delta R^2\)). Egy prediktor hatását csak az összes többi prediktor kontextusában tudjuk értelmezni. |
|
Hierarchikus (Blockwise / Theory-driven) |
Elméleti megalapozottsággal rögzített blokkokban adjuk hozzá a változókat (pl. 1. kontrollok \(\rightarrow\) 2. fő prediktorok \(\rightarrow\) 3. interakciók). | Hipotézistesztelés, zavaró változók kontrollja, mediációs/moderációs modellek előkészítése. | Szigorú elméleti megalapozást igényel; a beviteli sorrend megváltoztatása módosítja az \(R^2\)-növekmény értékét. |
|
Lépésenkénti (Stepwise / Algorithmic) • Forward • Backward • Stepwise |
Tisztán matematikai algoritmusok döntik el a változók bekerülését és kiejtését. A leggazdaságosabb modellt találja meg | Inkább feltáró, mintsem megerősítő elemzésekhez való | Hipotézistesztelésre nem ajánlott: túlzott illeszkedéshez, torzított SE-hez és felinflált elsőfajú hibához vezet, a szakmai megalapozottság elvész, hiába helyes matematikailag (Babyak, 2004; Harrell, 2015). |
A lépésenkénti (stepwise) módszer leírása:
Forward: először az a prediktor változó lép be, amelyiknek a legmagasabb a korrelációja az eredményváltozóval. Minden további változó az eredményváltozóval szembeni szemiparciális korrelációjának mértékében lép be. Egészen addig enged be a modell prediktorokat, amíg még szignifikáns eltérés van az előző lépéshez képest.
Backward: minden prediktor változót beenged, majd utólagosan ejti ki őket aszerint, hogy szignifikánsan befolyásolják-e a modellt (redundáns-e vagy sem).
Stepwise: először az a prediktor változó lép be, amelyiknek a legmagasabb a korrelációja az eredményváltozóval. Minden további változó az eredményváltozóval szembeni szemiparciális korrelációjának mértékében lép be. Egészen addig enged be a modell prediktorokat, amíg még szignifikáns eltérés van az előző lépéshez képest. De minden olyan előzőleg bent lévő változót kiejt, aminek így a szignifikanciája csökkent (tehát redundáns).
7.3 A többváltozós regresszió statisztikai mutatói és táblázatai
A statisztikai szoftverek (JASP, SPSS, R) kimenetei három központi táblára épülnek:
7.3.1 Az ANOVA tábla és az Omnibus F-teszt
A variancia felbontása megegyezik az egyszerű regressziónál látott logikával, a szabadságfokok azonban a prediktorok számához (p) igazodnak:
Modell négyzetösszege, megmagyarázott változatosság (\(SS_M\) vagy \(ESS\)): a modell által magyarázott variancia. Szabadságfoka \(df_M = p\)
Maradványok négyzetösszege (\(SS_R\) vagy \(RSS\)): a modell által nem magyarázott változatosság. Szabadságfoka \(df_R = n - p - 1\)
Teljes változatosság (\(SS_T\) vagy \(TSS\)): az adatok teljes varianciája az eredményváltozó átlaga körül. Szabadságfoka \(df_T = n - 1\)
Az átlagos négyzetösszegek (Mean Squares):
\[ MS_M = \frac{SS_M}{df_M} = \frac{SS_M}{p} \\ \text{és}\\ MS_R = \frac{SS_R}{df_R} = \frac{SS_R}{n-p-1} \]
Ez alapján az omnibus F-statisztika a már ismert képlet alapján:
\[ F = \frac{MS_M}{MS_R} \]
7.3.2 A Modell Summary tábla
A. Determinációs együttható (\(R^2\)): A függő változó teljes varianciájának azon része (hányada), amelyet a prediktorok lineáris kombinációja együttesen megmagyaráz. Vagyis érthetőbben: a megmagyarázott variancia és teljes variancia aránya. Ez alapján:
\[ R^2 = \frac{SS_M}{SS_T} \]
B. Theil-féle korrigált \(R^2\) (\(\text{adjusted } R^2\)): Mivel minden egyes új prediktor bevonása mesterségesen emeli az \(R^2\) értékét, a korrigált mutató „bünteti” az újabb prediktorok bevonását, a modell komplexitását és figyelembe veszi a mintaelemszámot is. Többszörös regressziónál a korrigált \(R^2\)-t közölni kell!
\[ \text{Korrigált }R^2 = 1 - \left[\frac{(1-R^2)(n-1)}{n-p-1}\right] \]
C. Hierarchikus modellek esetén változásmutatók: \(R^2\)-változás (\(\Delta R^2\)), F-változás (\(\Delta F\))
Azt méri, hogy az új változó(k) hozzáadása utáni új modell szignifikánsan több varianciát magyaráz-e, mint az azt megelőző modell:
\[\Delta F = \frac{\frac{R_2^2 - R_1^2}{p_2 - p_1}}{\frac{1 - R_2^2}{n - p_2 - 1}} = \frac{\frac{\Delta SS_M}{\Delta df}}{\frac{SS_{R2}}{df_{R2}}}\]
\[\Delta R^2 = \frac{SS_{R1} - SS_{R2}}{SS_T}\]
7.3.3 A Koefficiens tábla
Nem-sztenderdizált koefficiens (\(b_j\)): Megmutatja, hogy ha az adott \(X_j\) prediktor értéke 1 saját mértékegységgel növekszik, átlagosan mennyivel változik a függő változó (\(Y\)) a saját mértékegységében, minden más prediktort változatlan szinten tartva.
Standard hiba (\(SE_b\)): A becsült \(b_j\) együttható mintavételi bizonytalansága
Sztenderdizált béta (\(\beta_{j}\)): A regressziós egyenlet z-transzformált (standardizált) változókon számított meredeksége. Azt jelzi, hogy az \(X_j\) 1 szórásnyi (1 SD) növekedése hány szórásnyi változást hoz a kimeneti változóban (\(Y\)). Általa tudjuk összehasonlítani a prediktív erejét olyan prediktoroknak, amelyek eltérő skálájúak. Például életkor + 4-fokú likert skála + 7-fokú likert skála.
t-érték és szignifikanciája
A t-statisztika: a becsült regressziós meredekség (\(b_j\)) és a mintavételi bizonytalanságot leíró standard hiba (\(SE_{b_j}\)) hányadosa, ami azt fejezi ki, hogy a mintában talált parciális hatás hány standard hibányi távolságra esik a nullától. De gyakorlati értelmezése az, hogy a próba arra ad választ, hogy az adott prediktor változónak van-e egyedi, parciális magyarázóereje az eredményváltozóra, ha a többi prediktor hatásával kontrolláltunk.
Előjele megegyezik a b és β együtthatók előjelével: a pozitív t-érték egyenes arányú kapcsolatot, a negatív t-érték fordított arányú kapcsolatot jelez.
Amikor a t-értékeket jelentjük, szabadságfokként a maradványértékek szabadságfokát használjuk: \(df = n - p -1\).
Ha \(p < 0,05\), tehát a próbánk szignifikáns, akkor a prediktornak statisztikailag igazolható hatása van, ami nem mintavételi hiba.
Ha \(p > 0,05\), tehát a próbánk nem szignifikáns, akkor a prediktorunk magyarázóereje elhanyagolható a többi változó jelenlétében (redundáns vagy hatástalan).
\[ t = \frac{b_j}{SE_{b_j}} \] ahol \(df = n-p-1\)
A koefficiens tábla kapcsán érdemes megemlíteni, hogy ha két prediktor változó erősen korrelál egymással, akkor a becslés standard hibája (SE) felinflálódik, ami drasztikusan lecsökkenti a t-értéket. Vagyis előfordulhat, hogy a teljes modell globális F-tesztje erősen szignifikáns (\(p < 0{,}001\)), miközben az egyedi prediktorok t-tesztjei egyenként nem érik el a szignifikanciaküszöböt.
7.4 A többváltozós lineáris regresszió feltételei, feltételezései, diagnosztikája
flowchart LR
    %% Main Root
    ROOT["<b>Többszörös lineáris<br/>regresszió feltételei</b>"]

    %% 3 Main Pillars
    P1["<b>1. Minta- és adatjellemzők</b>"]
    P2["<b>2. Prediktor-struktúra</b>"]
    P3["<b>3. Reziduális diagnosztika</b>"]

    ROOT --> P1
    ROOT --> P2
    ROOT --> P3

    %% Pillar 1 Items
    P1 --> A1["`**Megfelelő mintaelemszám**
    • Modell szinten: *N ≥ 50 + 8p*
    • Egyedi bétákhoz: *N ≥ 104 + p*`"]
    P1 --> A2["`**Befolyásos és torzító értékek hiánya**
    • Standardizált vagy studentizált reziduumok: *|z| < 3*
    • Cook-távolság: *D < 4/(n-p-1)* vagy *D < 4/n*
    • Leverage h: *h = 3p/n < 0.2 vagy < 0.5*
    • Mahalanobis D²
    `"]

    %% Pillar 2 Items
    P2 --> B1["`**Linearitás és additivitás**
    • Változók közötti lineáris viszony`"]
    P2 --> B2["`**Nincs multikollinearitás**
    • Páronkénti korreláció: *r < 0,80*
    • *VIF < 2,5* (szigorú) vagy *VIF < 5*
    • Tolerancia *> 0,40* (szigorú) vagy *> 0,20*`"]

    %% Pillar 3 Items
    P3 --> C1["`**Hibák függetlensége (nincs autokorreláció)**
    • Durbin–Watson: *1.5 < DW < 2.5*`"]
    P3 --> C2["<b>Homoszkedaszticitás</b><br/>• Állandó hibavariancia<br/>• Nincs tölcsér alakú mintázat"]
    P3 --> C3["<b>A standardizált maradványértékek normalitása</b><br/>• Standardizált Q-Q ábra illeszkedése<br/>• Shapiro–Wilk teszt (p > 0.05)"]

    %% Styling for visual hierarchy
    style ROOT fill:#1a365d,stroke:#0f172a,color:#ffffff,stroke-width:2px
    style P1 fill:#e2e8f0,stroke:#475569,stroke-width:1.5px
    style P2 fill:#e2e8f0,stroke:#475569,stroke-width:1.5px
    style P3 fill:#e2e8f0,stroke:#475569,stroke-width:1.5px

    style A1 fill:#ffffff,stroke:#cbd5e1,stroke-width:1px
    style A2 fill:#ffffff,stroke:#cbd5e1,stroke-width:1px
    style B1 fill:#ffffff,stroke:#cbd5e1,stroke-width:1px
    style B2 fill:#ffffff,stroke:#cbd5e1,stroke-width:1px
    style C1 fill:#ffffff,stroke:#cbd5e1,stroke-width:1px
    style C2 fill:#ffffff,stroke:#cbd5e1,stroke-width:1px
    style C3 fill:#ffffff,stroke:#cbd5e1,stroke-width:1px
7.4.1 Megfelelő mintaelemszám (N)
Tabachnick és Fidell (2019) alapján a teljes modell (\(R^2\)) teszteléséhez \(N \ge 50 + 8p\) érték az irányadó, az egyes \(\beta_j\) teszteléséhez \(N \ge 104 + p\) irányadó. Például 3 prediktor változó esetén a modellhez minimum \(50 + 8 \times 3 = 74\) fő, az egyedi bétákhoz \(104 + 3 = 107\) fő szükséges.
7.4.2 Linearitás és additivitás
A prediktorok és a kimeneti változó között a kapcsolat lineáris és additív (nincsenek nem modellezett görbevonalú összefüggések). Ellenőrzése: a Residuals vs. Predicted szórásdiagramon a pontok vízszintes sávban, mintázatmentesen szóródnak a 0 vonal körül.
(Ha ez sérül, akkor nemlineáris transzformációra van szükség vagy polinomiális regressziót alkalmazunk, amit ez a könyv nem tárgyal.)
7.4.3 Nincs multikollinearitás
A prediktorok túl erős egymás közötti korrelációja rontja a becslés stabilitását, mesterségesen felinflálja a standard hibákat (\(SE_b\)), instabillá teszi a béta-értékeket és csökkenti a statisztikai erőt.
Páronkénti korrelációk: \(r < 0{,}80\)
Tolerancia (Tolerance): Annak a varianciának a hányada, amit a többi prediktor nem magyaráz meg. \(\text{Tolerancia}_j = 1- R^{2}_{j}\). Elvárás, hogy az értéke legyen legalább \(\ge 0{,}2\) vagy szigorúbb szabály szerint \(\ge 0{,}4\).
Variancia-inflációs tényező (VIF): A standard hiba felinflálásának mértéke. Gyakorlatilag a tolerancia érték inverze: \(\text{VIF}_j = \frac{1}{\text{Tolerance}} = \frac{1}{1-R^{2}_j}\). Elvárás: \(\text{VIF} < 5\) vagy szigorúbb szabály szerint \(\text{VIF} < 2{,}5\). (Legenyhébb elvárás egyes kutatók gyakorlata alapján 10.)
7.4.4 Kiugró értékek, befolyásos pontok
Studentizált maradványértékek: A reziduumokat Student-féle t-eloszlás alapján standardizálja, majd kilistázza azokat az egyedi eseteket, ahol a reziduum 3-nál nagyobb σ-ra van a reziduumok átlagától.
Leverage h mutató: 0–1 közötti érték. Azt méri, hogy egy adatpont a prediktor változók (X) terében mennyire messze van az átlagtól és azt mutatja meg, hogy mekkora fizikai „erőkarja” van (ti. leverage) egy adott pontnak arra, hogy elforgassa a regressziós egyenest (mintha „kiülne a libikóka szélére”). Nem azt méri, hogy adott pont elrontja-e a modellt, mert nem minden magas leverage-dzsel rendelkező pont befolyásos is (influential). Megfelelő az eset h-értéke, ha < 0,2 (de legalább < 0,5). Más szerzők szerint a kritériumszint inkább \(< \frac{2(p)}{n}\), de a JASP a szigorúbb, vagy kisebb mintaelemszámhoz jobban illő \(< \frac{3(p)}{n}\) kritériumszintet használja. Ennél a mutatónál a p-be beletartozik az intercept is, ha szignifikáns.
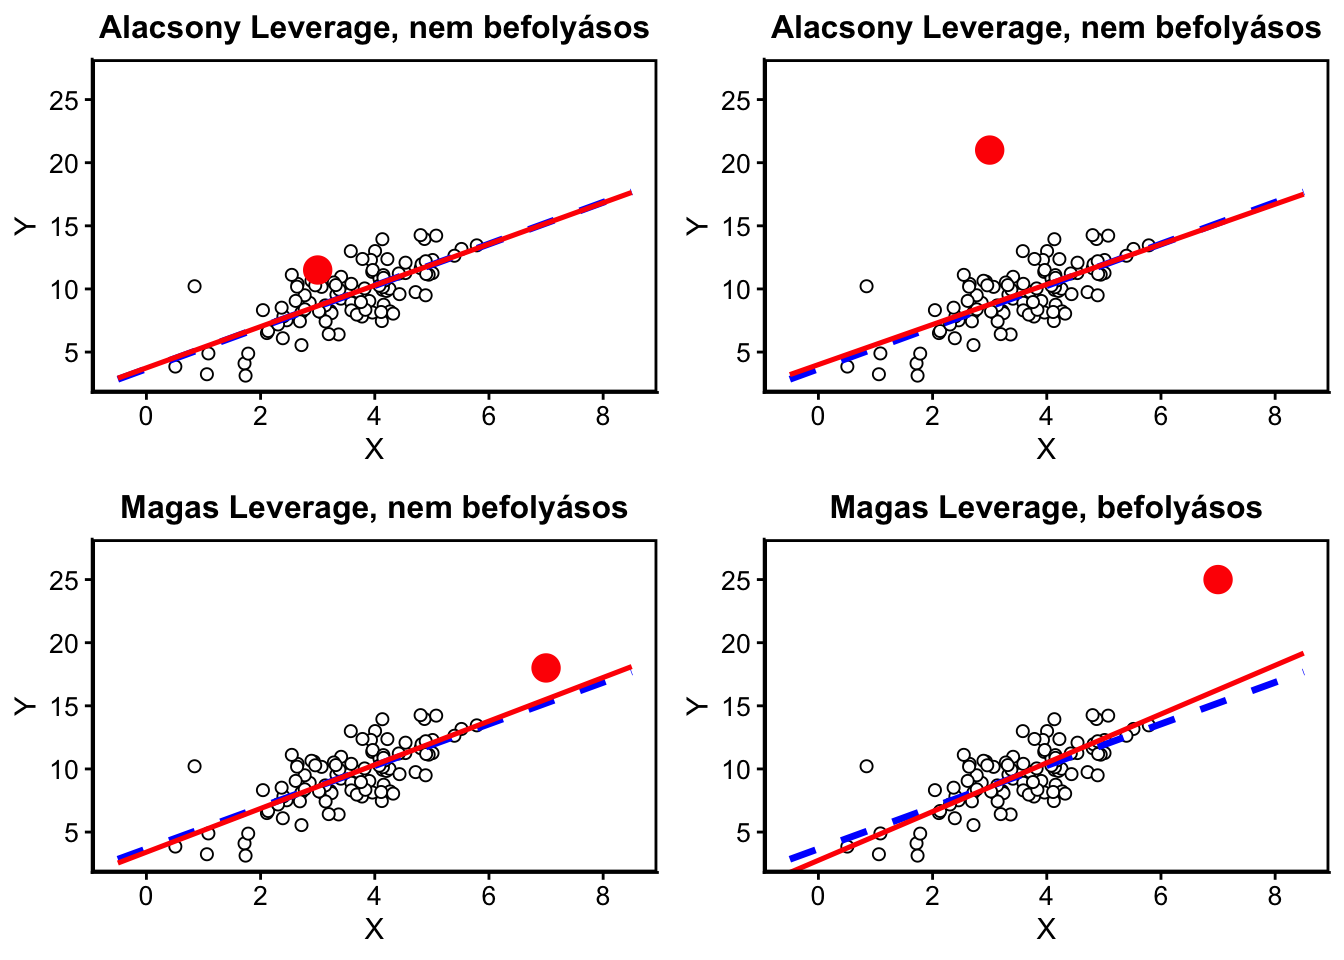
- Cook-féle távolság (D): Behatóbban meg kell vizsgálni azokat az eseteket, ahol a D érték nagyobb, mint \(\frac{4}{n-p-1}\) vagy más szerzők szerint \(\frac{4}{n}\). Egy nagyon régi ökölszabály az 1-es kritériumszint, de ez csak \(n < 30\) elemszámnál használható ma.
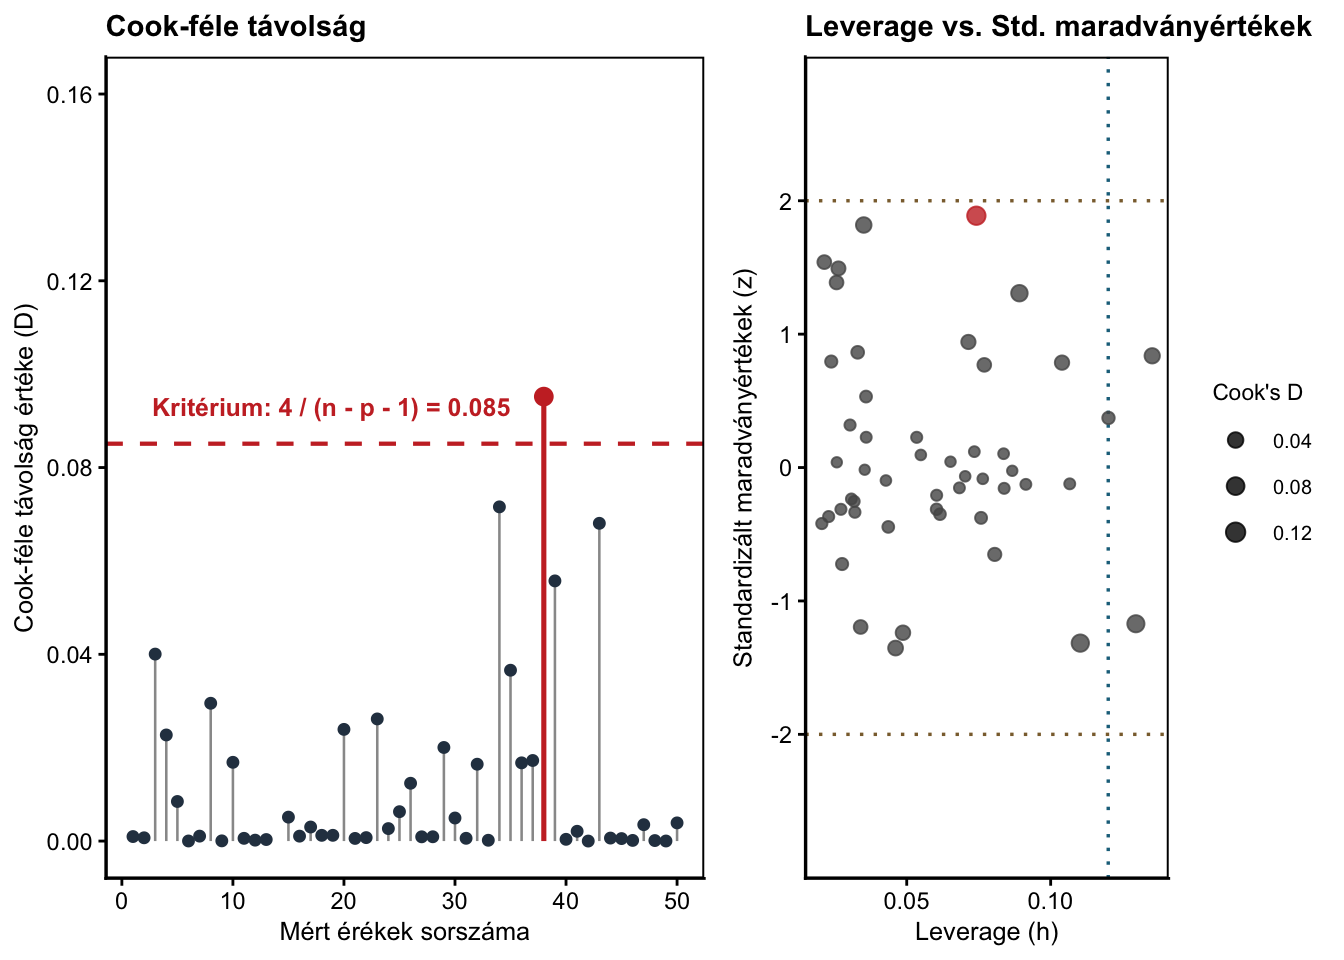
A két ábra együtt megmutatja a regressziós becslést aránytalanul befolyásoló mért értékeket: a bal oldali ábra mutatja, melyik eset lépi át a Cook-féle távolság küszöbét, míg a jobb oldali ábra megmutatja a befolyásosság mértékét a hiba nagysága (z) és a prediktortérbeli eltérés (h) kombinációjában. Meg kell vizsgálni a 38. alany nyers adatait (félregépelés, skálázási hiba, speciális alpopuláció), majd lefuttatni a modellt a 38-as esettel és anélkül. Ha a regressziós együtthatók lényegesen változnak, meg kell vizsgálni a DFBETA értékeket, és a publikációban mindkét modell eredményét (vagy robusztus regressziós analízist) célszerű bemutatni. Automatikus, indoklás nélküli adateltávolítást sosem végzünk!
- DFBETA: Azt méri, hogy egy eset kihagyása hány standard hibányit módosít egy konkrét b_j paraméteren. Küszöbérték: \(|\text{DFBETA}| > \frac{2}{\sqrt{n}}\).
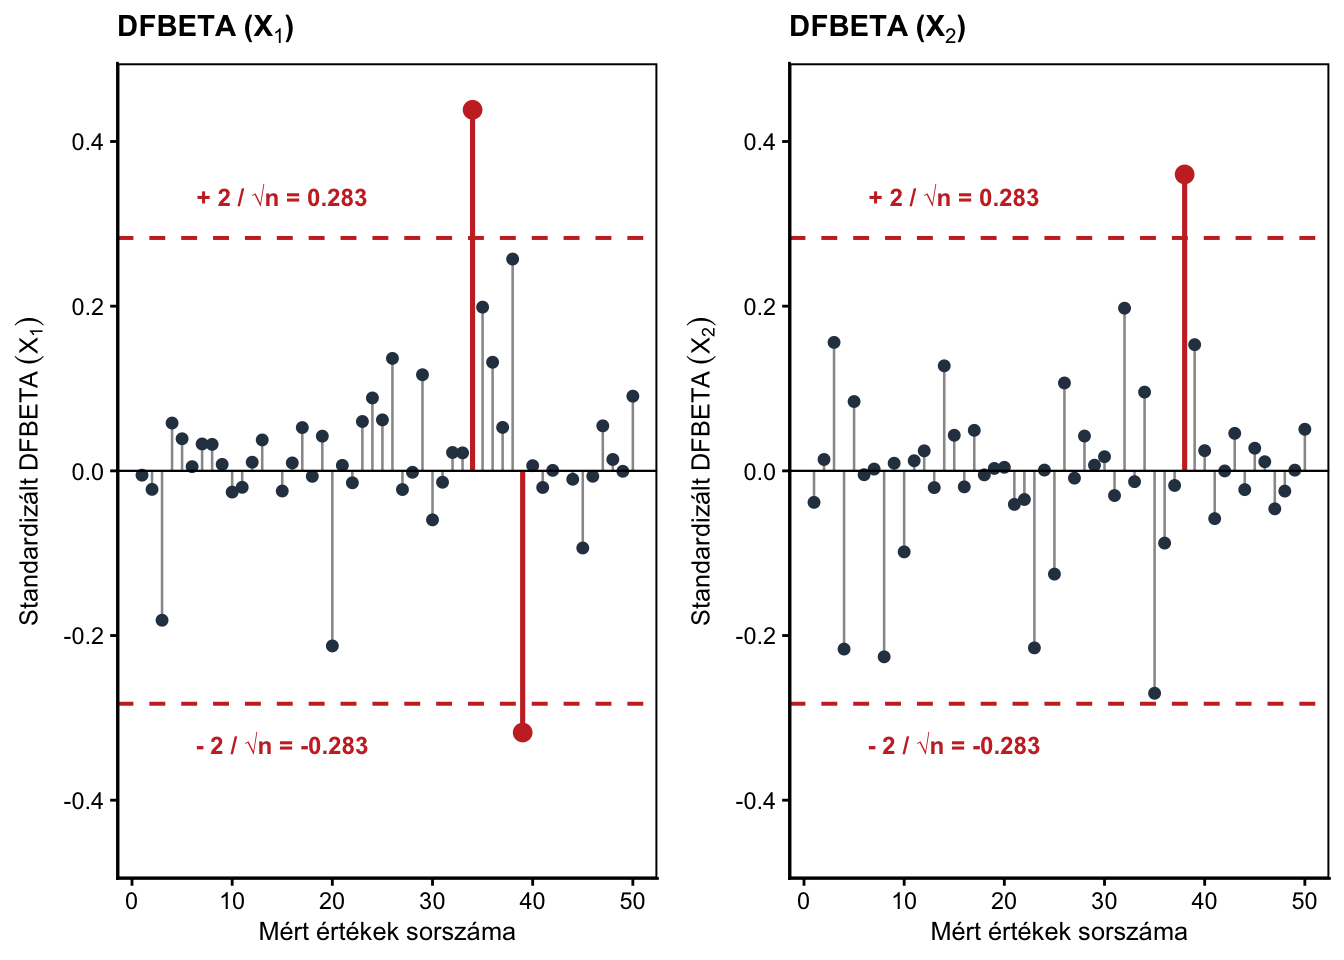
A DFBETA-ábra azt vizsgálja, hogy egy-egy konkrét személy (kitöltő) kizárása vagy benntartása hány standard hibányit (SE) változtat egy adott prediktor változóhoz tartozó regressziós együtthatón. A fenti ábrán minden függőleges vonal egy-egy résztvevő adatát képviseli, külön vizsgálva az X1 prediktor változóra és X2 prediktor változóra gyakorolt hatását. A piros szaggatott vonalak a kritériumszintek. A bal oldali ábrán a 34-es válaszadó egymagában felfelé „húzza” az X1 prediktorváltozó meredekségét (mesterségesen felfelé torzítva ezáltal a kimutatott összefüggést), míg a 39-es válaszadó lefelé. Az ilyen értékek azonosítása a pszichológiai kutatásokban azért fontos, mert segít azonosítani, hogy van-e egy-két kirívó résztvevő, akin múlhat a hipotézis szignifikanciája vagy a talált összefüggés erőssége.
- Mahalanobis-féle távolság: Azt mutatja meg, hogy milyen távol van az eset a centrumtól. Többváltozós kiugró pontokat szűrünk vele \(\chi^2(df=p)\) eloszlással \(p < 0{,}001\) szignifikancia mellett. Kritikus értékei adott szabadságfokú khí-négyzeteloszlás alapján kiszámíthatók. A szabadságfok pedig a prediktorok száma (intercept nélkül). A könnyebb alkalmazhatóság érdekében egy rövid táblázat segít néhány szabadságfok (prediktorszám) alapján:
| Szabadságfok | Mahalanobis-féle távolság kritikus értéke |
|---|---|
| 2 | 13,81551 |
| 3 | 16,26624 |
| 4 | 18,46683 |
| 5 | 20,51501 |
| 6 | 22,45774 |
| 7 | 24,32189 |
| 8 | 26,12448 |
| 9 | 27,87716 |
| 10 | 29,58830 |
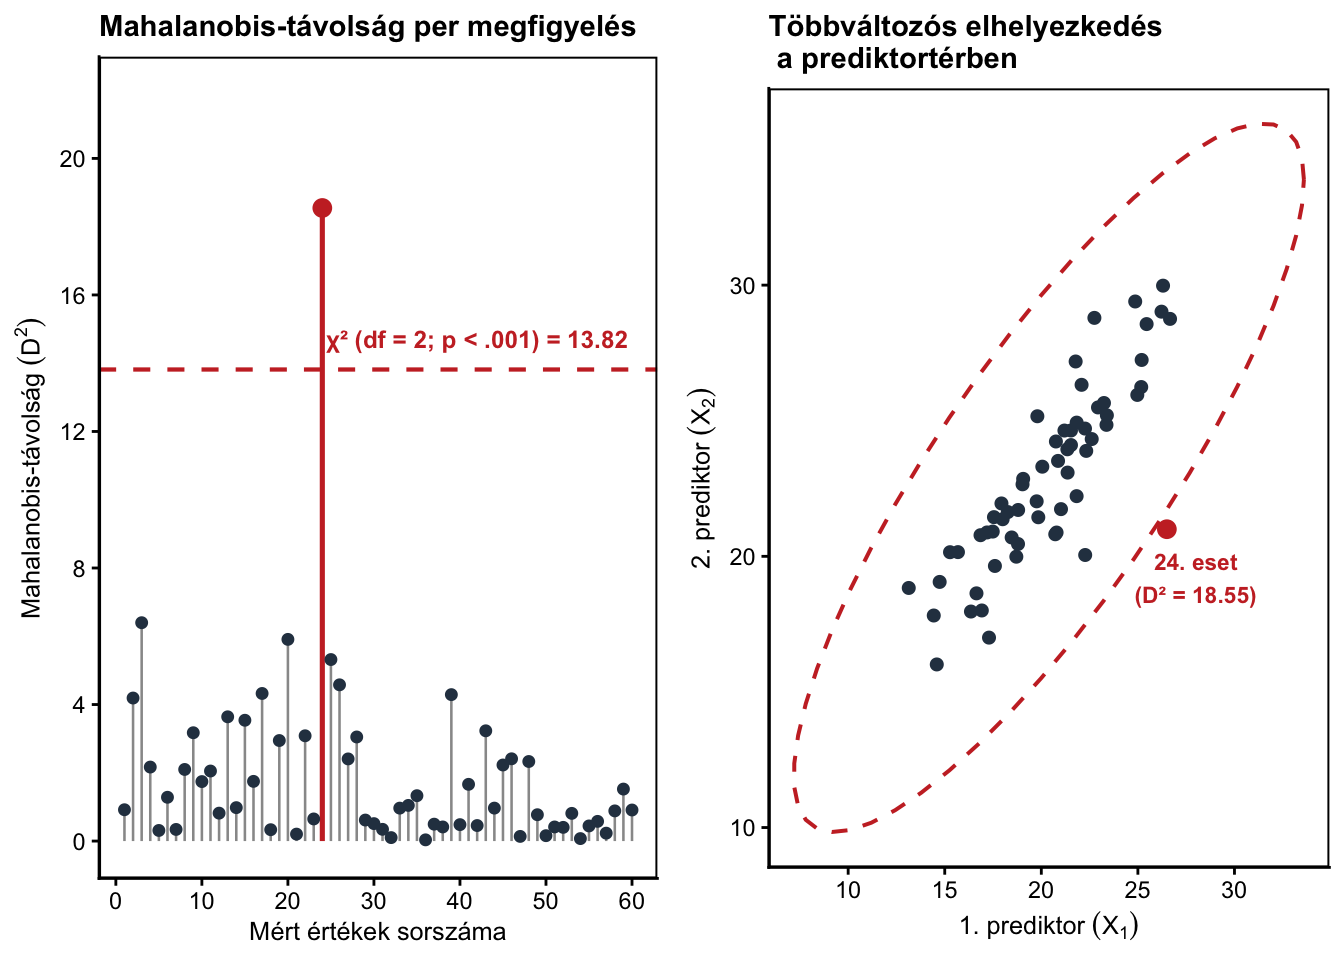
A Mahalanobis-távolság segítségével a többdimenziós kiugró értékeket (multivariate outliers) azonosítjuk a predikor változók (X) együttes eloszlásában. A bal oldali ábrán a mért értékek távolságát látjuk a minta közös többváltozós átlagától. A jobb oldali ábra viszont jól szemlélteti a módszer gyakorlati hasznát az egyváltozós normalitásvizsgálatokkal szemben: a 24-es válaszadó önállóan egyik prediktorváltozón sem számít extrém értéknek, de a prediktorok közötti természetes korrelációs mintázatot felbontó kombinációja azonban a szaggatott vonallal jelzett prediktortér 99,9%-os konfidencia-ellipszisén kívülre „helyezi” őt. Az ilyen esetek jelenléte eltorzíthatja a kovarianciamátrixot és félrevezetheti a parciális hatások becslését.
Teendők:
Adatrögzítési és mérési hibákat ellenőrizzük
Kérdőívbe épített figyelmi itemeket ellenőrizzük (kitöltési megbízhatóság)
Érzékenységvizsgálatot végzünk: lefuttatjuk a modellt a válaszadó nélkül is, és ha se a magyarázóerő (R2), se a standardizált meredekségek nem változnak jelentősen, akkor a választ bent hagyjuk.
Robusztus lineáris regressziós modelleket alkalmazunk, ami nem tananyag.
7.4.5 A maradványértékek függetlenek (nincs autokorreláció)
A maradványértékek ideálisan nem korrelálhatnak egymással. Ha a modellbe minden odaillő prediktor változót integráltunk, akkor a maradványértékek természetes „zajok”. Azonban ha mintázat (főleg korreláció) van a maradványértékek között, akkor valószínűleg kihagytunk egy fontos tényezőt. Az autokorrelációt új változó modellbe integrálásával tudjuk mérsékelni, megszüntetni. Longitudinális vagy klaszterezett adatok esetén GLS, idősorelemzés vagy multilevel modellezés lehet a megoldás. Ez nem része a tankönyvnek.
Durbin–Watson (DW) próba
\[ \text{DW} = \frac{\sum^n_{t=2}{(e_t-e_{t-1})^2}}{\sum^n_{t=1}{e_t^2}} \]
Értéktartománya 0 és 4 közötti. A DW mutatónak van alsó és felső határa, amit az SPSS kiszámol, amire alapozhatjuk az elfogadást függvényszerűen. De a JASP nem számolja ki (kéziratkori verziószám esetén). Ezért az alábbi szabályrendszert használjuk:
- Ha \(DW \approx 2{,}0\), akkor optimális maradványértékeink vannak, nincs köztük autokorreláció.
- Ha \(DW < 1{,}5\), akkor pozitív autokorreláció van a maradványértékeinkben, ami idősoros adatoknál jellemző lehet
- Ha \(DW > 2{,}5\), akkor negatív autokorrelációról beszélhetünk.
Ha nagyon szeretnénk, akkor az SPSS által is kiszámolt kritériumszinteket a változók száma és mintaelemszám alapján ebből a táblázatból ki tudjuk olvasni: DW kritériumszintek.
A JASP (illetve R) viszont egy autokorrelációs értéket is kiszámít, aminek a képlete: \(\hat{\rho} = 1 - \frac{DW}{2}\). Ha értéke 0, akkor DW = 2,0. Ha 0,4 akkor DW = 1,2, ami valószínűleg erős pozitív autokorrelációt jelent. Ha -0,4, akkor DW = 2,8, ami valószínűleg erős negatív autokorrelációt jelent.
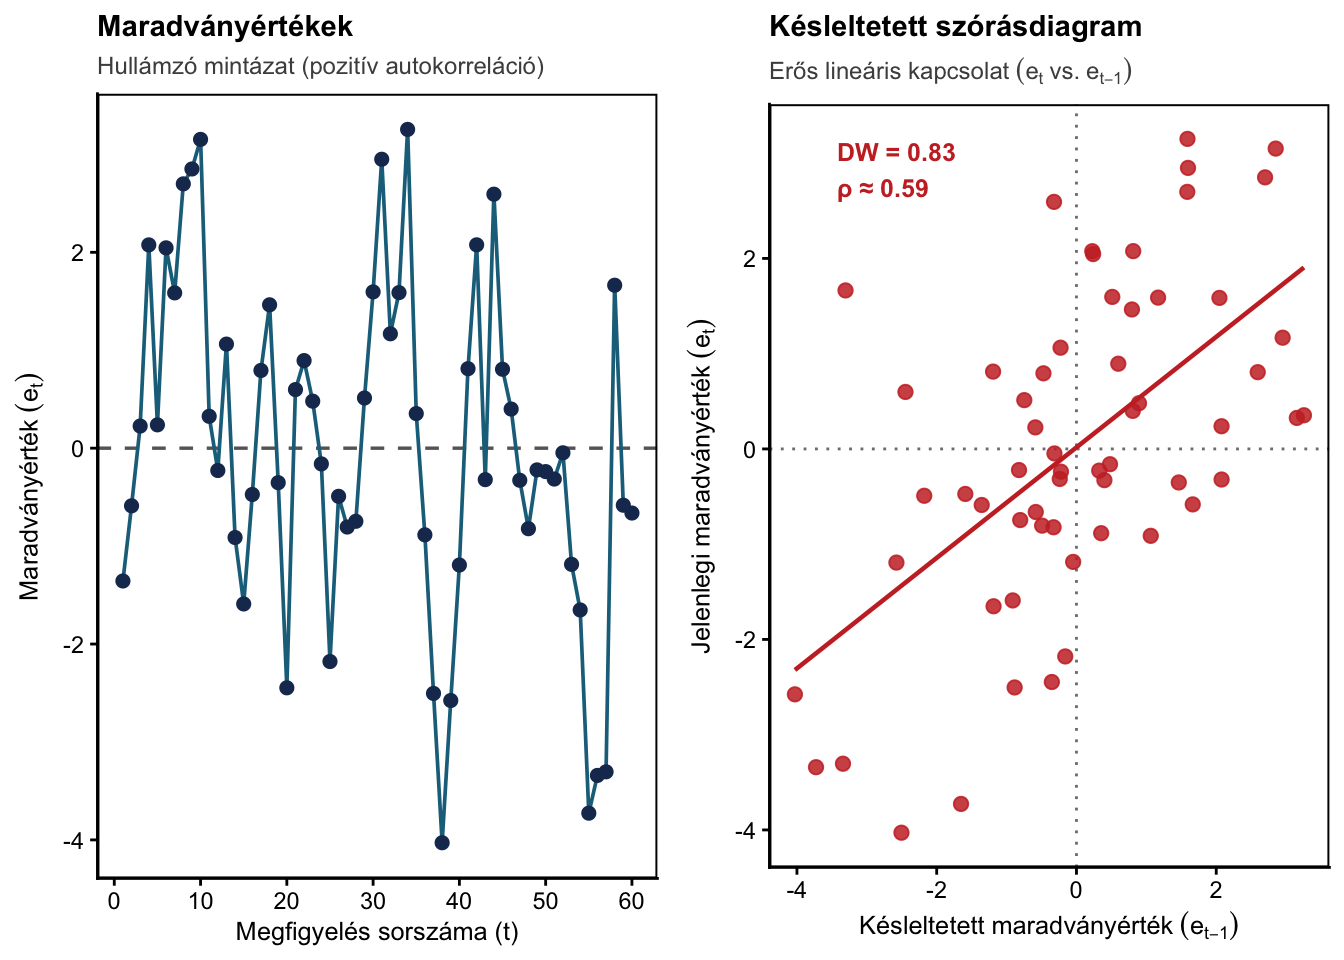
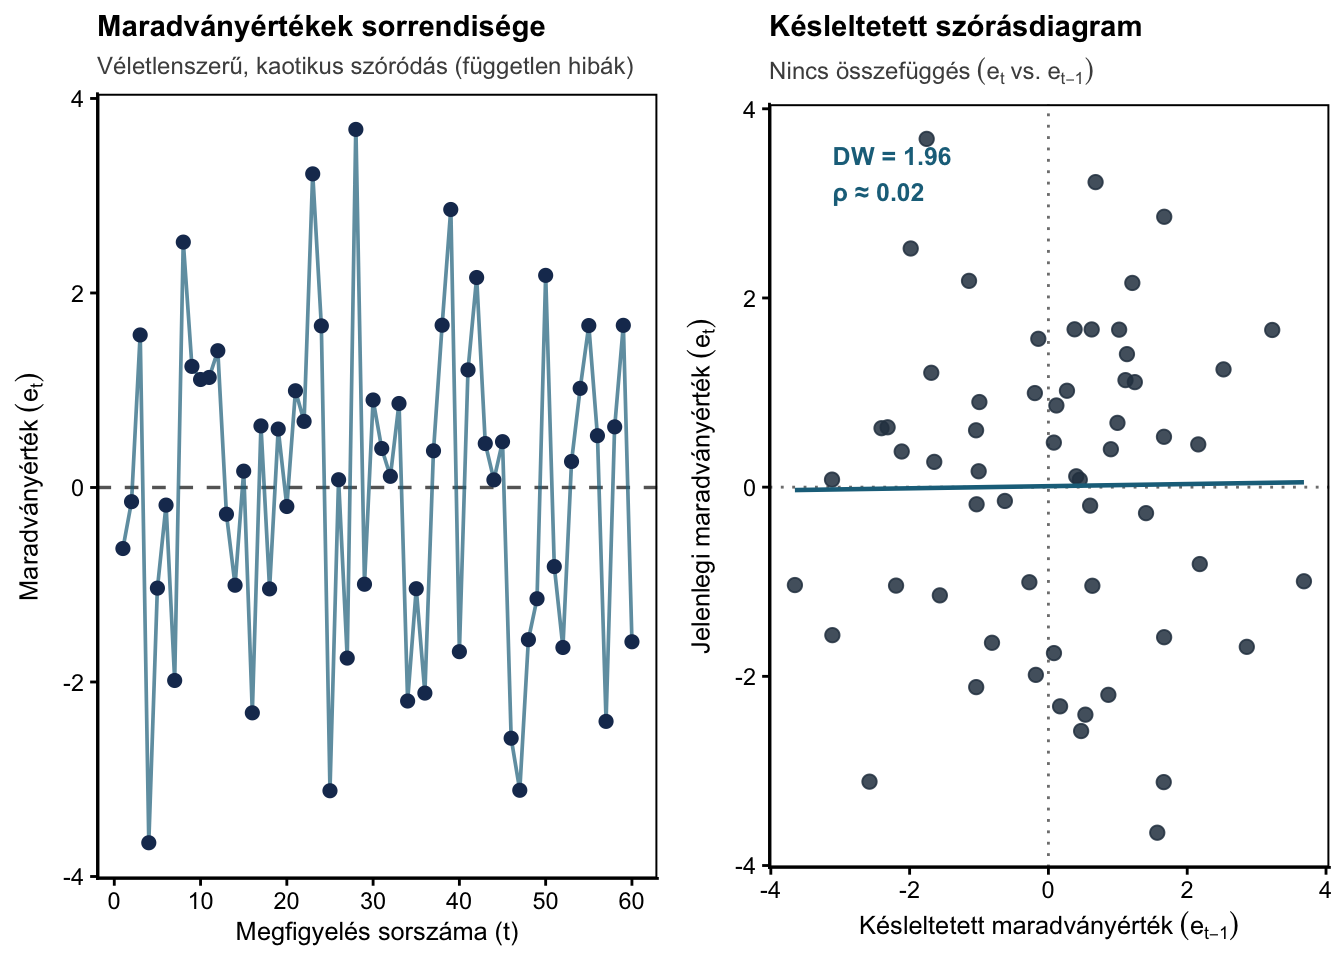
A bal oldali ábra egy sorrendi ábra. Pozitív autokorreláció esetén a maradványértékek „hullámokat” képeznek: a pozitív hibákat tartósan pozitív hibák követik, a negatívakat pedig negatívak. Független adatok esetén ezzel szemben a pontok kaotikusan ugrálnának a nulla tengely körül.
A jobb oldali ábra (Lag-1 késleltetett szórásdiagram) ábrázolja az i-edik megfigyelés maradványértékét az azt közvetlenül megelőző megfigyelés maradványértékének függvényében. Így az autokorreláció egyértelmű lineáris összefüggésként jelenik meg, láthatjuk, hogy erős pozitív korreláció van a maradvdányértékek között.
7.4.6 Homoszkedaszticitás (szóráshomogenitás)
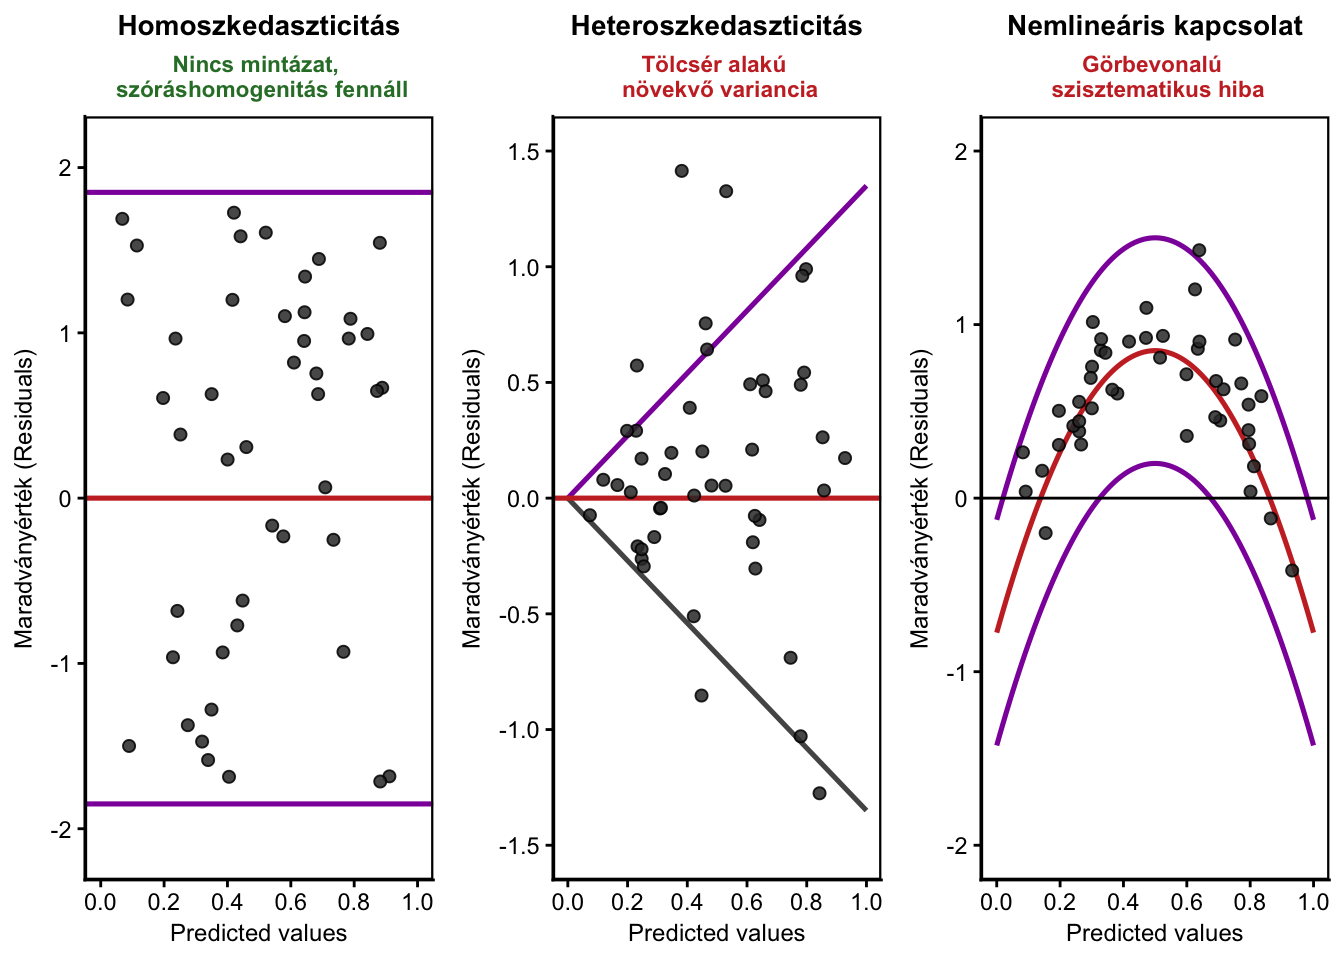
Fontos feltétel, ahogy a különbségvizsgálatoknál is láttuk, hogy a szórások homogének legyenek. Ez a lineáris regresszió esetén ismét a maradványértékekre igaz, mégpedig olyan formában, hogy a maradványértékek szórása az összes predikált szinten állandó.
A Residuals vs. Predicted scatter ploton a szóródás nem képezhet tölcsér- vagy ék alakot, mert az heteroszkedaszticitást jelent, ami a feltétel sérülése. Ha pedig görbe a mintázata, akkor a kapcsolat nem lineáris.
7.4.7 A standardizált maradványértékek normál eloszlása
A maradványértékeket standardizáljuk, és megvizsgáljuk, hogy normál eloszlást követnek-e. A reziduális hisztogram és standardizált Q-Q ábra alapján azt várjuk, hogy a 45 fokos vonalon helyezkedjenek el az ábrázolt pontok. Valamint a kiexportált standardizált maradványértékeken végzett normalitáspróba (pl. Shapiro-Wilk) ne legyen szignifikáns.
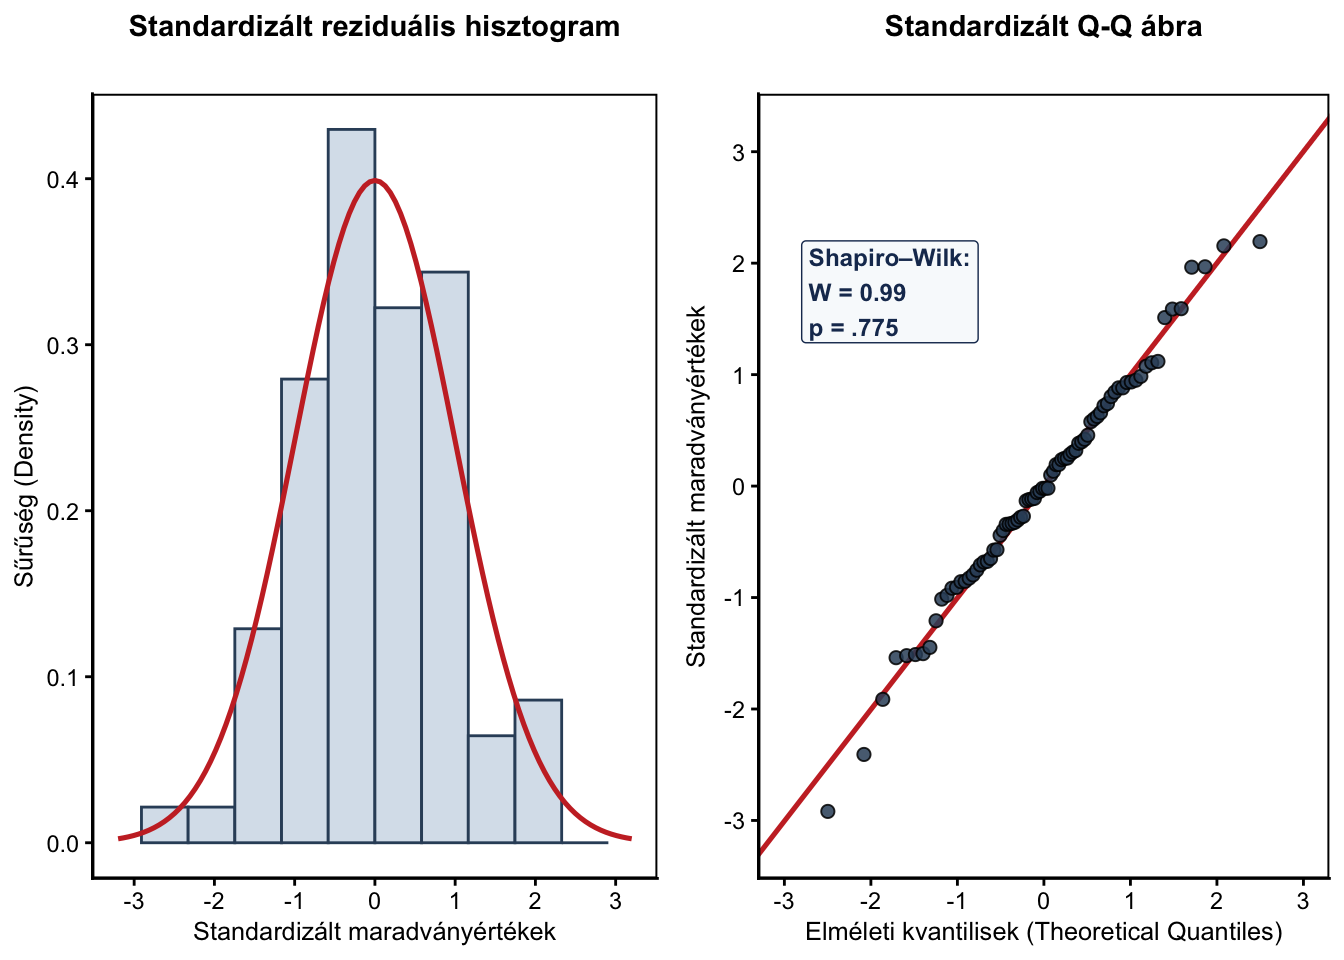
A jobb oldali Q-Q plot (kvantilis-kvantilis ábra) a maradványértékek eloszlását veti össze a normál eloszlás elméleti pontjaival. Ha a feltétel teljesül, a pontok szorosan a 45 fokos piros referenciavonalra illeszkednek.
7.5 Az eredmények bemutatása
A leírásban fel kell tüntetni a következőket:
- Kutatói kérdés és modell rövid megfogalmazása
- Volt-e egydimenziós outlier, amit kivettünk az adathalmazból az adattisztítás során
- Volt-e többdimenziós outlier, amit kivettünk az adathalmazból (Mahalanobis, Cook, stb. alapján)
- Változók rövid bemutatása
- Linearitás feltételeinek teljesülése
- Multikollinearitás feltételeinek teljesülése (elég egy közülük: VIF, tolerancia)
- Homoszkedaszticitás teljesülése (grafikonnal)
- Maradványértékek normalitásának leírása
- Maradványértékek autokorrelációja (korrelálatlansága)
- Modell felépítése
- Modell értelmezése szövegesen és táblázat publikálása
Példa 7.1 (Kiégés vizsgálata) Felnőtt mintánkon (n = 207) kiégést vizsgáltunk teljesítményfüggő önbecsülés, szociális támogatás és önkritika függvényében. Vizsgált változóink:
- Életkor
- Születési nem
- Kiégés pontszám 7 itemes kérdőívvel, 5-fokú Likert skálán (max 35 pont)
- Teljesítményfüggő önbecsülés pontszám 14 itemes kérdőívvel, 7-fokú Likert skálán (max 98 pont)
- Önkritikusság pontszám 8 itemes kérdőívvel, 7-fokú Likert skálán (max 56 pont)
- Szociális támogatás pontszáma 10 itemes kérdőívvel, 6-fokú Likert skálán (max 60 pont)
A kutatásunkban 102 fő férfi és 105 fő nő vett részt. A mintánk leíró statisztikai mutatóit az alábbi táblázat foglalja össze:
| M | SD | Min | Max | Skew | Kurt | |
|---|---|---|---|---|---|---|
| Életkor | 31,899 | 6,500 | 18 | 47 | 0,040 | -0,601 |
| Kiégés | 19,826 | 3,133 | 13 | 28 | 0,609 | -0,145 |
| Teljesítményfüggő önbecsülés | 60,010 | 11,933 | 30 | 90 | 0,203 | -0,143 |
| Önkritikusság | 22,130 | 4,245 | 11 | 34 | 0,082 | -0,005 |
| Szociális támogatás | 35,222 | 7,377 | 18 | 52 | 0,233 | -0,158 |
Előzetes feltételezésünk, hogy a kiégést a tényezők az alábbi erősségi sorrendben befolyásolják a kiégést:
- teljesítményfüggő önbecsülés
- önkritikusság
- szociális támogatás
Az adatsor itt letölthető: hierlinreg.sav
A JASP-ot az alábbi formában állítjuk be a vizsgálat lefuttatásához:
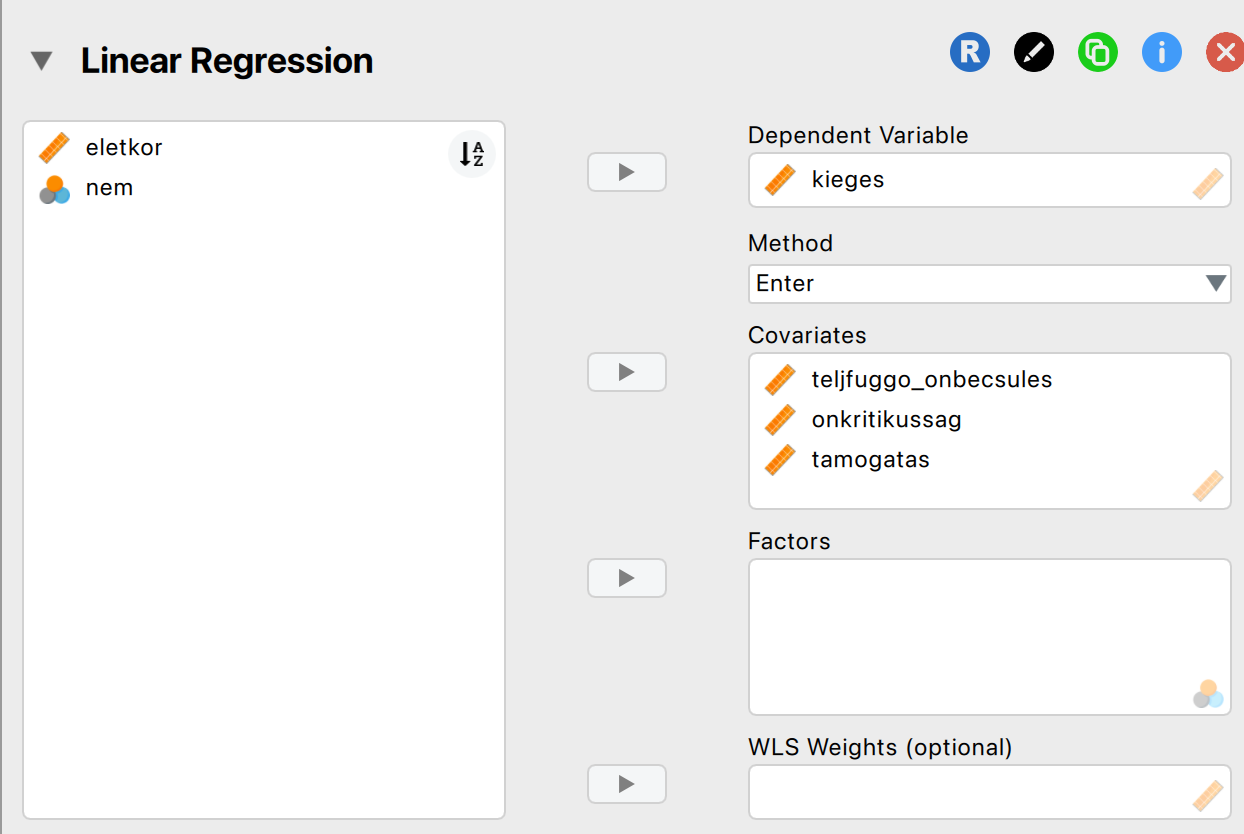
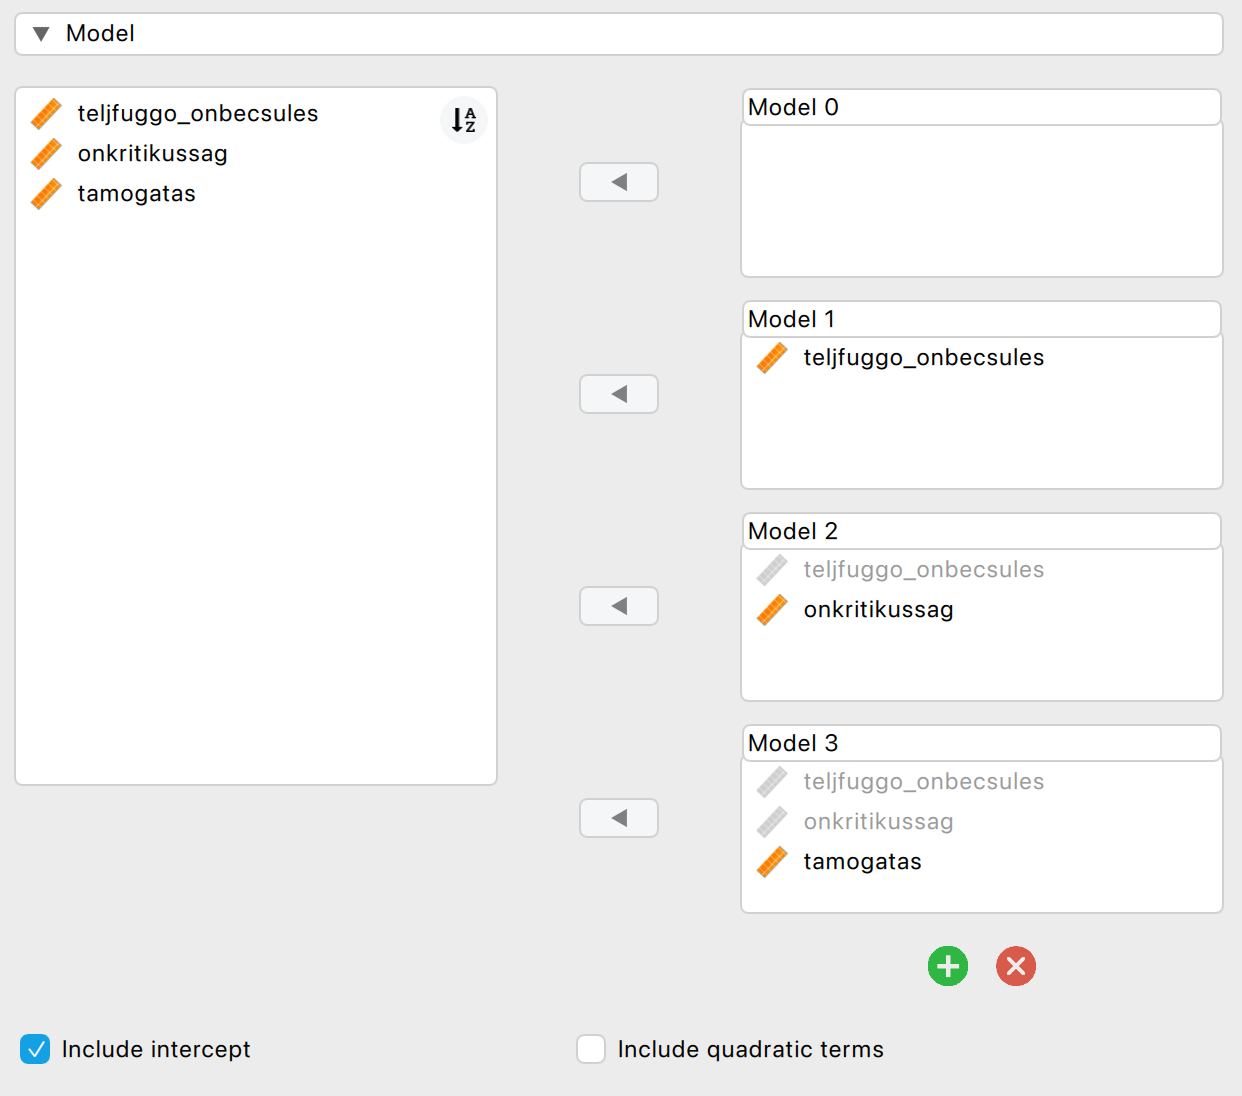
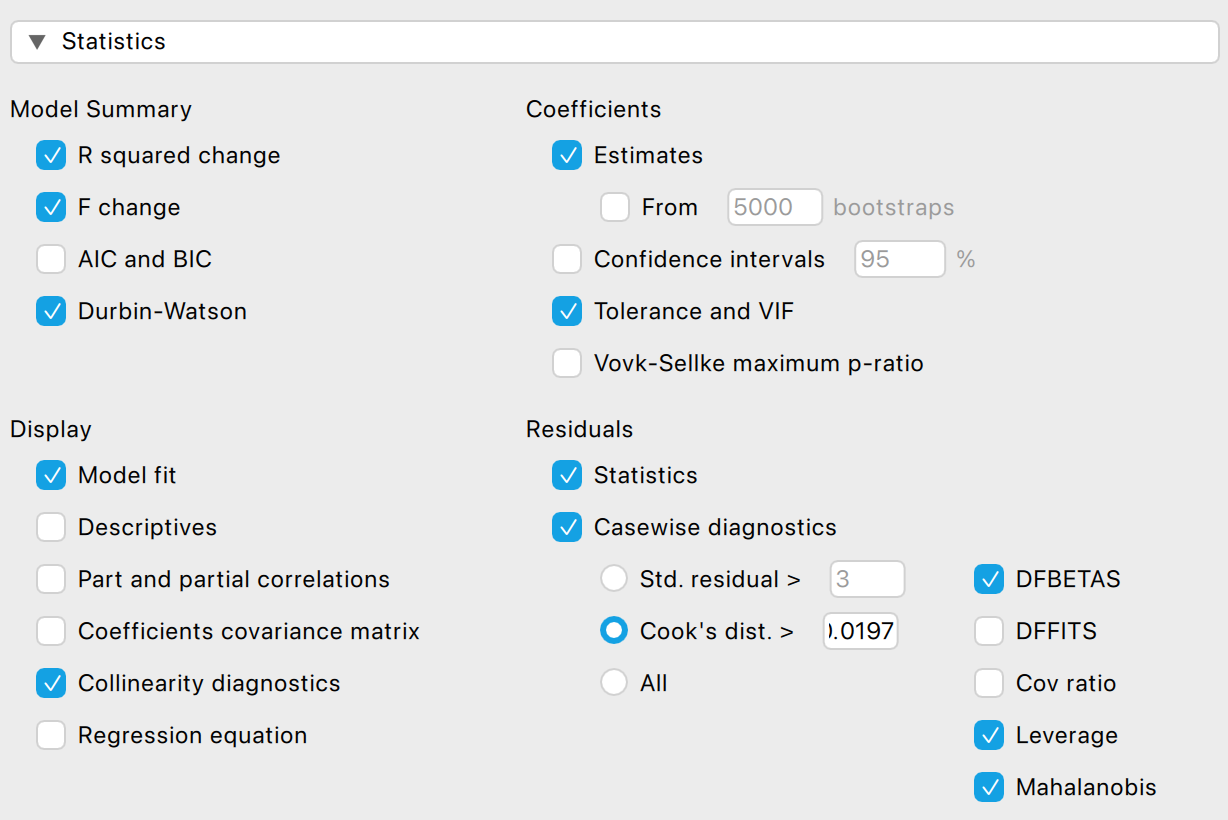
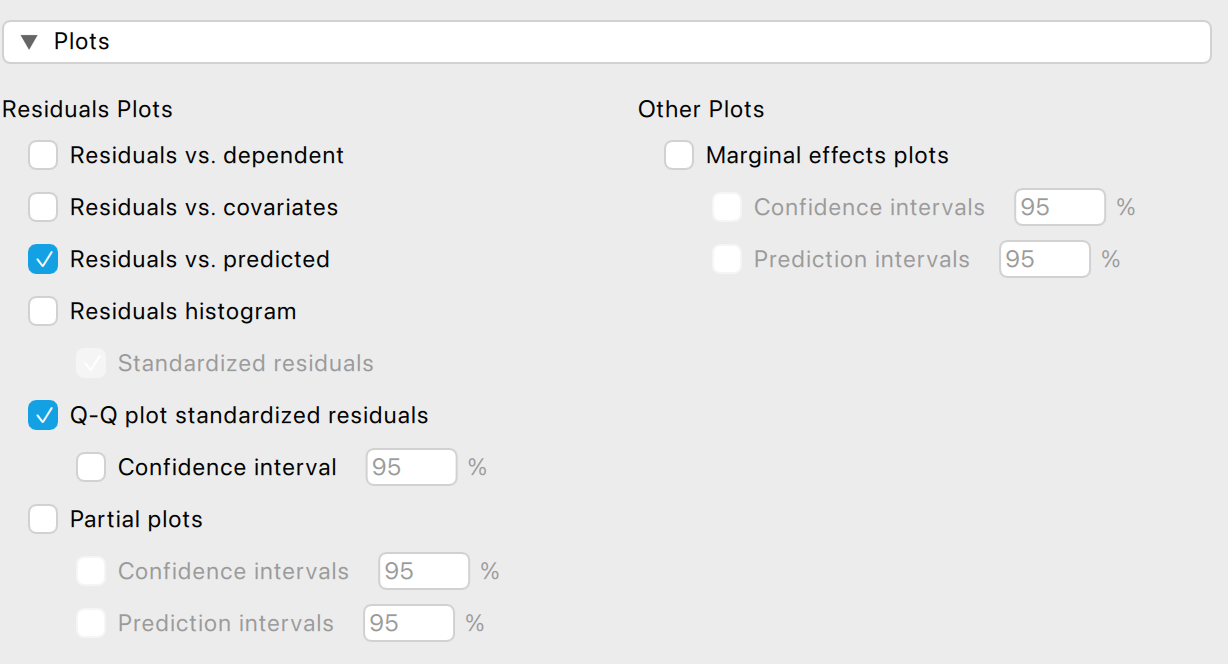
Olvassuk le az eredményeinket elsősorban:
- Modell táblázat
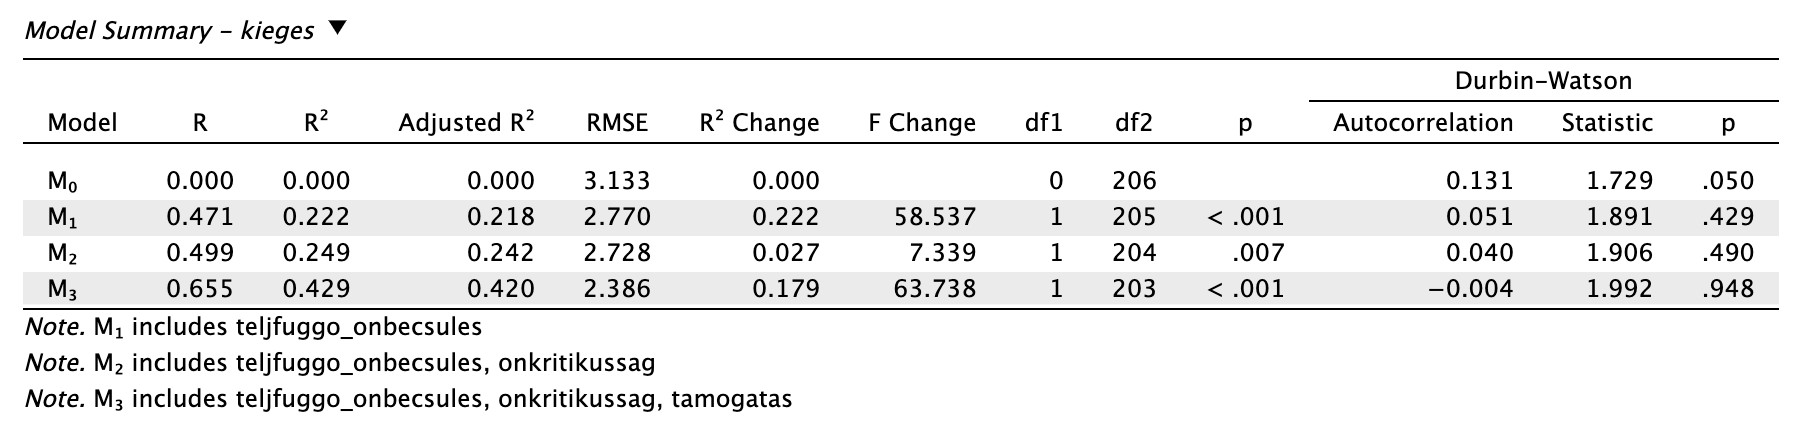
Mivel hierarchikus modelleket építettünk fel azért, hogy minden egyes új prediktor bevonását alaposan értékelni tudjuk, értékeljük a modelleket egyesével:
- Modell 1
Az alábbi paramétereket nézzük meg első körben:
Modell-szignifikancia: ellenőrizzük a modell p-értékét, célunk, hogy szignifikáns legyen, mert ekkor a prediktor változónk változása ténylegesen befolyásolja a kimeneti változónkat: p < 0,001. Szignifikáns.
Magyarázóerő: a modellunk a kimeneti változóban (a kiégés mértékében) található variancia mekkora hányadát magyarázza: R2 = 0,222, korrigált R2 = 0,218 (ez utóbbit értékeljük!), vagyis a teljesítményfüggő önbecsülés a kiégés varianciájának 21,8%-át magyarázza
F-érték: A kezdeti modellilleszkedés: F(1, 205) = 58,537.
Durbin-Watson mutató: a maradványértékek autokorrelációja. Célunk, hogy az érték 2,0 körüli legyen: DW = 1,891 > 1,5, így kijelenthetjük, hogy a hibák (maradványértékek) az M1-ben függetlenek (nincs autokorreláció)
- Modell 2
Modell-változás szignifikanciája: ellenőrizzük a modellváltozás p-értékét: p = 0,007. Szignifikáns. (A tényleges modell p-értékét az ANOVA táblából olvassuk le.)
Magyarázóerő: a modellunk a kimeneti változóban (a kiégés mértékében) található variancia mekkora hányadát magyarázza: R2 = 0,249, korrigált R2 = 0,242 (ez utóbbit értékeljük!), vagyis a teljesítményfüggő önbecsülés és az önkritikusság együttesen a kiégés varianciájának 24,2%-át magyarázza. Láthatjuk, hogy a magyarázati erő növekedése (R2 change) csupán (0,249 - 0,222 =) 0,027 (2,7 százalékpontnyi növekmény). Korrigált mutatót vizsgálva (0,242 - 0,218 =) 0,024 (2,4 százalékpontnyi növekmény). Ez csekély változás.
F-érték változása: A magyarázóerő-növekmény F-tesztje: ΔF(1, 204) = 7,339 (A nominális F-értékeket az ANOVA táblából tudjuk leolvasni)
Durbin-Watson mutató: a maradványértékek autokorrelációja. Célunk, hogy az érték 2,0 körüli legyen: DW = 1,906 > 1,5, így kijelenthetjük, hogy a hibák (maradványértékek) az M2-ben függetlenek (nincs autokorreláció)
- Modell 3
Modell-változás szignifikanciája: ellenőrizzük a modellváltozás p-értékét: p < 0,001. Szignifikáns. (A tényleges modell p-értékét az ANOVA táblából olvassuk le.)
Magyarázóerő: a modellunk a kimeneti változóban (a kiégés mértékében) található variancia mekkora hányadát magyarázza: R2 = 0,429, korrigált R2 = 0,420 (ez utóbbit értékeljük!), vagyis a teljesítményfüggő önbecsülés és az önkritikusság együttesen a kiégés varianciájának 42%-át magyarázza. Láthatjuk, hogy a magyarázati erő növekedése (R2 change) jelentős: 0,179 (17,9 százalékpontnyi növekmény). Korrigált mutatót vizsgálva (0,420 - 0,242 =) 0,178 (17,8 százalékpontnyi növekmény). Ez jelentős magyarázóerő-növekmény.
F-érték változása: A magyarázóerő-növekmény F-tesztje: ΔF(1, 203) = 63,738 (A nominális F-értékeket az ANOVA táblából tudjuk leolvasni)
Durbin-Watson mutató: a maradványértékek autokorrelációja. Célunk, hogy az érték 2,0 körüli legyen: DW = 1,992, így kijelenthetjük, hogy a hibák (maradványértékek) az M3-ban függetlenek (nincs autokorreláció).
- ANOVA tábla
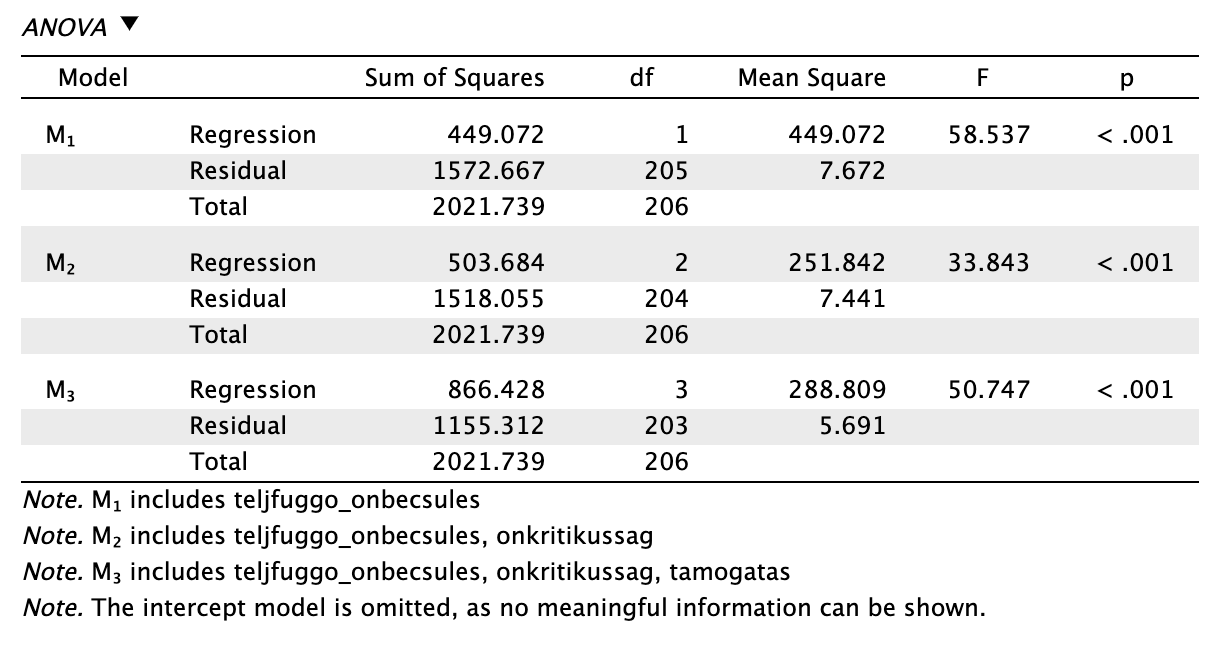
Az ANOVA táblából tudjuk leolvasni az egyes modellek F-értékét a hozzájuk tartozó szabadságfokokkal. Ezek NEM ugyanazok, mint az F-érték változásnál látható szabadságfokok, és a p-értékek sem ugyanazok. Az itt szereplő p-értékek a modellünk szignifikanciái (nem pedig a változásé). Az itt lévő értékeket fogjuk a folyószövegben bemutatni.
- Koefficiens tábla
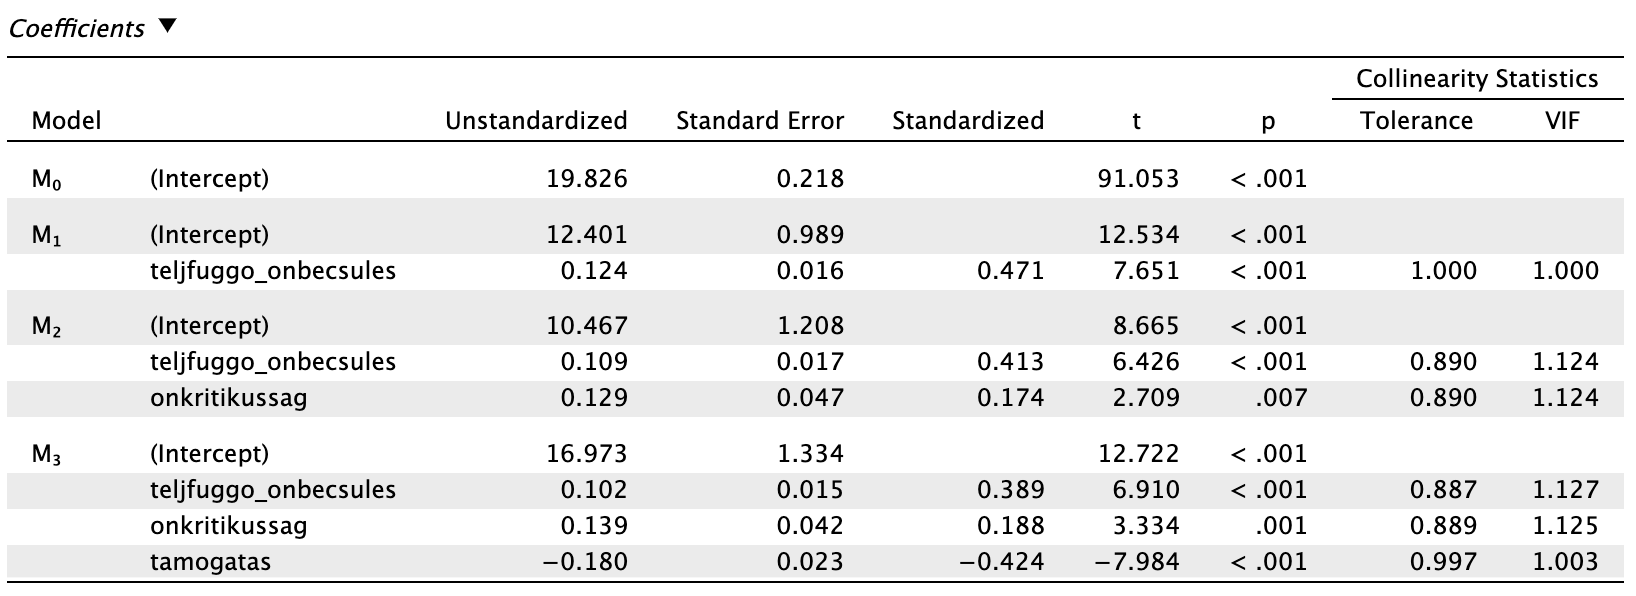
Innen tudjuk leolvasni a következőket:
- Azt, hogy az egyes prediktor változók szignifikánsan befolyásolják-e a kiégés mértékét, és ha igen, milyen irányban és mértékben:
M1: a teljesítményfüggő önbecsülés p-értéke szignifikáns, tehát a változó szignifikánsan befolyásolja a kiégés mértékét. A Standardised mutató a béta-együttható mutatja meg a „befolyásolás mértékét”: 0,471.
M2: a teljesítményfüggő önbecsülés p-értéke továbbra is szignifikáns, tehát a változó szignifikánsan befolyásolja a kiégés mértékét, de a béta-együttható csökkent 0,413-ra, tehát az önkritikusságot is figyelembe véve (vele kontrollálva) a teljesítményfüggő önbecsülés hatása csökken. Az önkritikusság prediktor változó is szignifikáns (p = 0,007), a béta-együttható 0,174.
M3: a harmadik modellben is mindegyik prediktor változó szignifikáns (p-értékek), tehát mindhárom befolyásolja a kiégés mértékét. A béta-értékek azonban láthatjuk, hogy ellentétes hatások figyelhetőek meg. A teljesítményfüggő önbecsülés továbbra is pozitív módon predikálja (β = 0,389) a kiégés mértékét, de még kisebb mértékben, mint az M2-ben. Az önkritikusság hatása nőtt (β = 0,188). Ezzel szemben láthatjuk, hogy a szociális támogatás csökkenti a kiégés mértékét (majd értelmezhetjük protektív faktorként): β = -0,424.
- Ha már itt vagyunk, nézzünk rá a kollinearitást vizsgáló mutatókra
Láthatjuk, hogy a Tolerance mértéke minden esetben nagyobb, mint a szigorú 0,4-es határ. Vagy ugyanúgy, a VIF értéke kisebb, mint 2,5. Tehát kijelenthetjük, hogy multikollinearitás nem áll fenn. Tehát a becslés ebből a szempontból stabil.
- Diagnosztika
Az alábbi listát nézzük végig a legutolsó szignifikáns modellünknél (jelen esetben az M3).
Mintaelemszám megfelelő-e
Befolyásos és torzító értékek: Cook-féle távolság, Leverage h és Mahalanobis D2
Multikollinearitás hiánya (ezt leolvastuk a koefficiens táblából már, teljesült)
Hibák függetlensége, nincs autokorreláció (ezt leolvastuk a modell táblából, ez is teljesült)
Homoszkedaszticitás (a hibavariancia állandó)
A standardizált maradványértékek normál eloszlást követnek.
Nézzük meg egyesével azokat, amiket még nem vizsgáltunk:
- Mintaelemszám megfelelősége:
A minimális mintaelemszám a modell szintjén N ≥ 50 + 8p = 50 + 8*3 = 74. Ennek megfelelünk.
Az egyes béta-értékekhez tartozó minimális mintaelemszámunk: 104 + p = 104+3 = 107. Ennek is megfelelünk.
- Befolyásos és torzító értékek
Számítsuk ki a Cook-féle távolság kritikus értékét. A JASP eredetileg defaultként 1-t tartalmaz, de ekkora elemszámnál ez nem indokolt, ezért kiszámítjuk az egyik képlet szerint az általunk alkalmazott kritériumszintet. (Ezt majd a Módszerek részben le kell írni!)
\(\frac{4}{n-p-1} = \frac{4}{207 - 3 - 1} = 0,0197044335 \approx = 0,0197\)
Négy tizedesjegynél többet nem tudunk beírni a JASP-ba, ezért ‘,0197’ értéket írunk be a mezőbe, és listázni fogja a JASP az összes olyan választ, ahol ennél magasabb a Cook-féle D távolság.
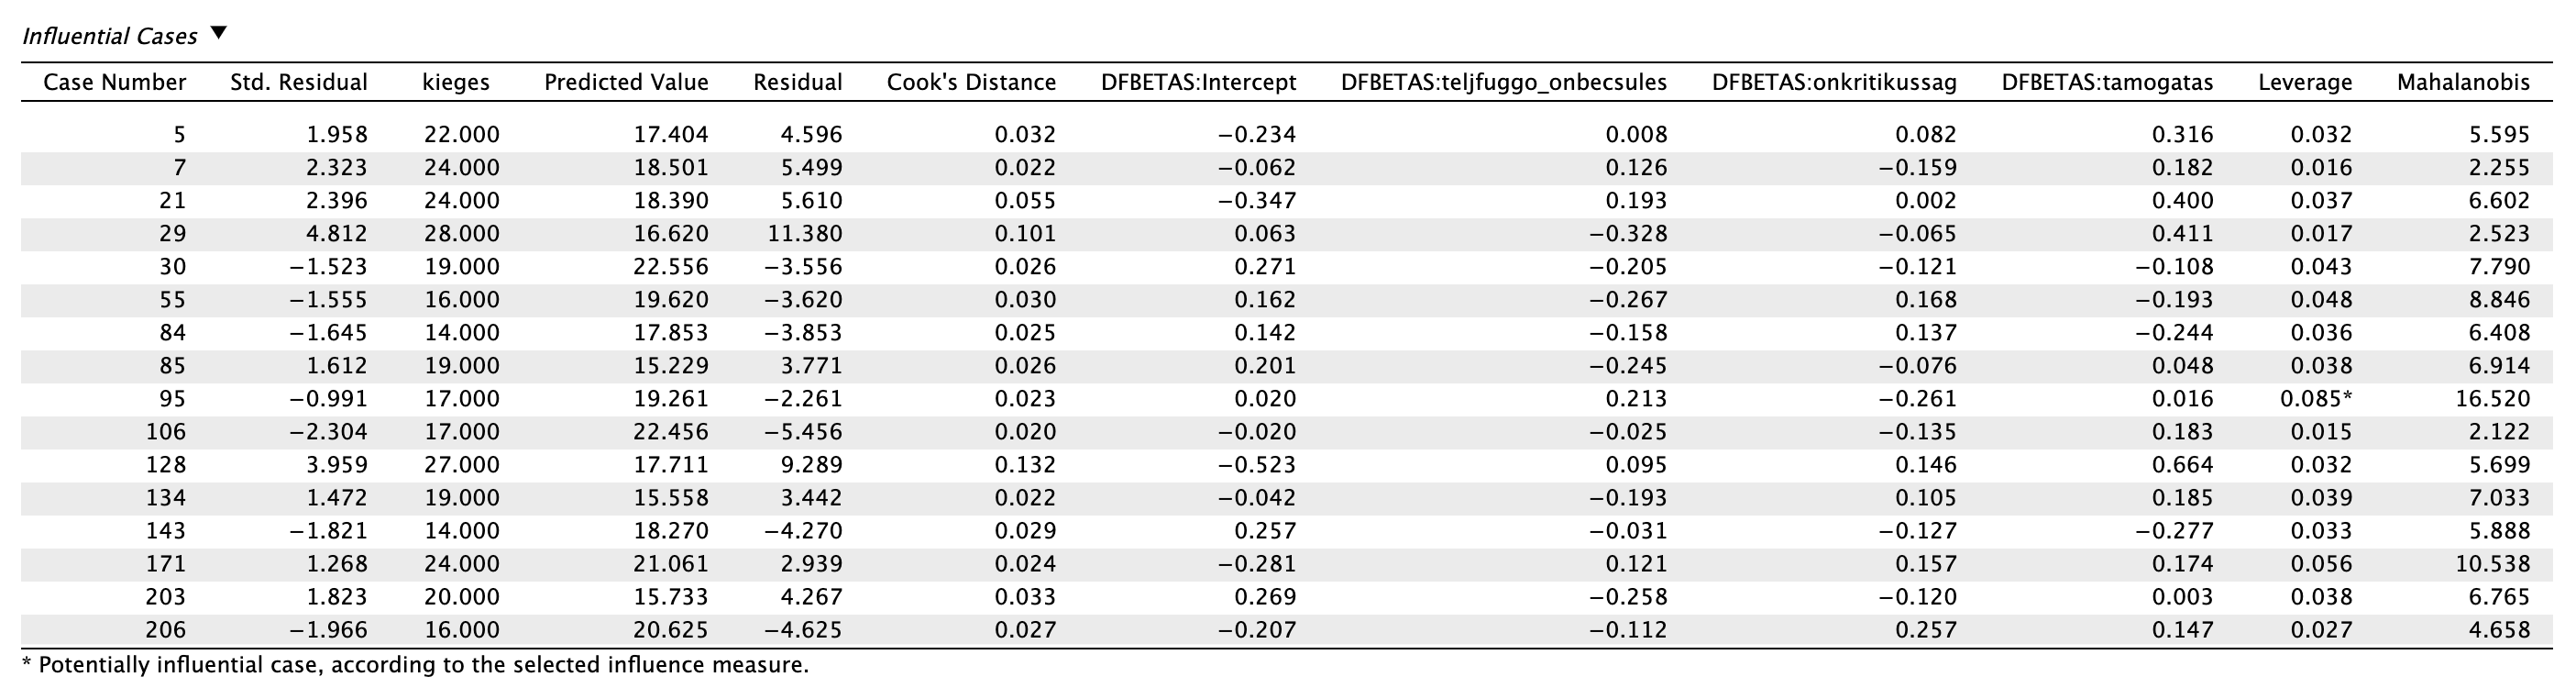
Láthatjuk, hogy a Cook-féle távolság több esetben meghaladja ezt a kritériumszintet, bár egyik sem éri el az 1 értéket. Érdemes egymáshoz képest megvizsgálni őket, hogy melyek azok, amelyek kiugróak a többihez képest. Láthatjuk, hogy a 29-es válasz (0,101) és a 128-as válasz (0,132) a legkiemelkedőbb. Egyelőre elraktározzuk ezt az információt.
Nézzük meg, hogy ezeknél az eseteknél van-e kiemelkedő Leverage h érték. A JASP automatikusan kiszámolja nekünk a kritériumszintet, ezzel nem kell törődnünk. Csillaggal jelöli azt a választ, ami meghaladja ezt a kritériumot. A kritérium amúgy \(h = 3 \frac{p}{n}\). Ha az interceptünk szignifikáns, akkor az is beletartozik a p értékébe. Tehát \(h = 3 \frac{3+1}{207} = 0,05797\).
Láthatjuk, hogy a Cook-féle távolság szerint kiugró értékek listájában a 95-ös válasznak magas a Leverage h értéke (0,085).
Válasszuk ki a beállításokban az “All” opciót, hogy megnézzük, van-e más pont, ami a kritériumszint fölött van. Láthatjuk, hogy ilyen még a 133-as válasz (0,064).
A Mahalanobis D2 érték esetén a kritériumszintünk 16,26624, mert a szabadságfok értéke 3 (3 prediktor változónk van intercept nélkül, és a táblázatból kiolvastuk, hogy ahhoz mekkora D2 kritérium tartozik). Láthatjuk, hogy egy db változónk van ebben a listában, amelynek magasabb az értéke, ez pedig a 95-ös válasz. Ez a válasz kilóg a prediktortér ellipsziséből.
Válasszuk ki a beállításokban az “All” opciót, hogy megnézzük, van-e más pont, ami a D2-hez tartozó kritériumszint fölött van. Láthatjuk, hogy nincs ilyen a 95-ös válaszon kívül.
- Multikollinearitás hiánya
Ezt ellenőriztük a koefficiens táblán a Tolerance és VIF értékekkel. A feltétel teljesül: nincs multikollinearitás.
- Hibák függetlensége
Ezt ellenőriztük a modell táblán a Durbin-Watson értékekkel. Mivel az M3-ban 1,992 értéket vett fel, szinte tökéletesen az elvárt 2,0 érték körül helyezkedik el: a hibák függetlenek, nincs autokorreláció.
- Homoszkedaszticitás
Megvizsgáljuk, hogy a hibavariancia állandó-e. Ezt a Plots rovatban álltjuk be, ahogy fentebb láttuk.
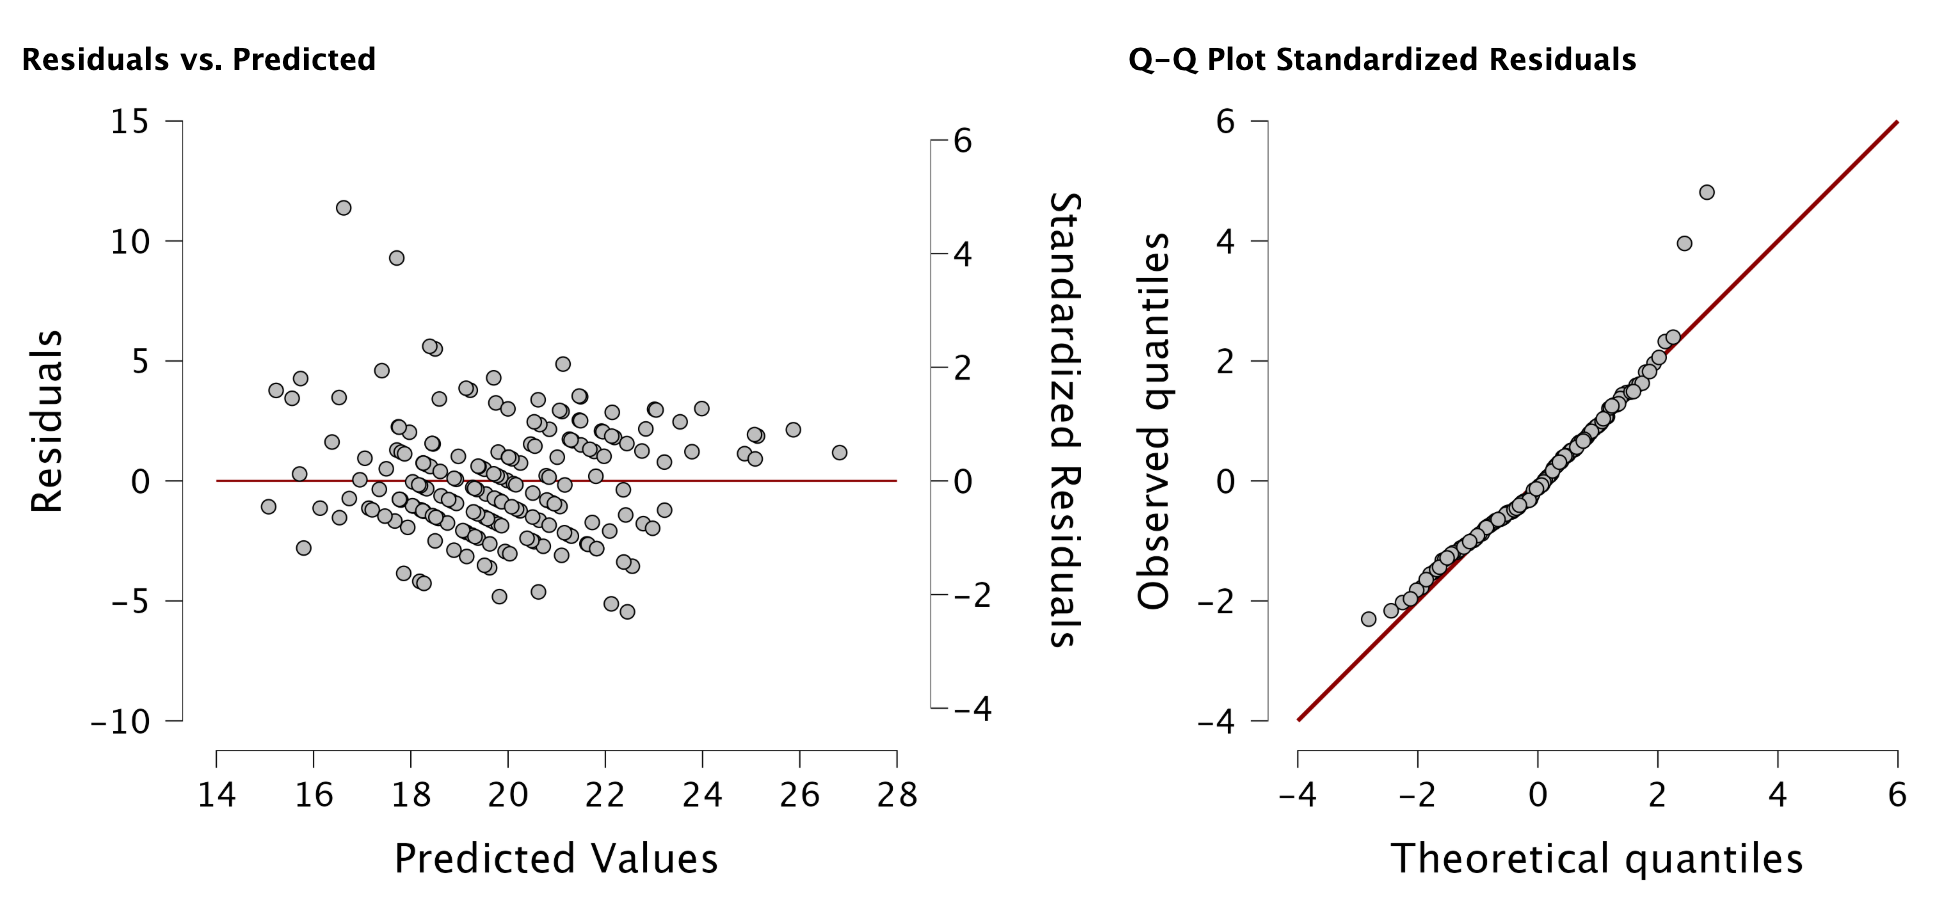
Láthatjuk, hogy nincs tölcséralak, se görbe, a homoszkedaszticitás vizuális szemrevételezés alapján fennáll.
- A standardizált maradványértékek normál eloszlást követnek
A standardizált maradványértékek Q-Q plotja alapján megvizsgáljuk, hogy szemrevételezés alapján normál eloszlást követnek-e a hibatagok, és azt láthatjuk, hogy igen.
Statisztikai próbával a korábbról más ismert Export funkció segítsévégel tudjuk majd ellenőrizni: a standardizált maradványértékeket kiexportáljuk új oszlopként, majd a leíró statisztikai modulban Shapiro-Wilk próbát futtatunk rajta:
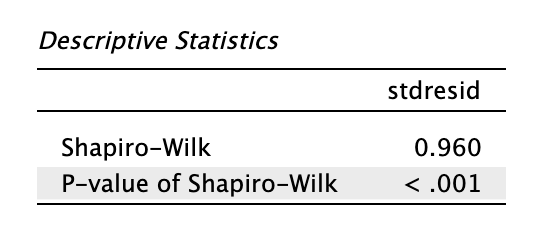
A Shapiro-Wilk próba alapján (ami nagy mintaelemszámnál túl érzékeny) viszont azt láthatjuk, hogy szignifikáns, tehát a maradványértékek NEM követik a normál eloszlást.
- Diagnosztika utáni szenzitivitás-elemzés
Megvizsgáljuk, hogy van-e hibás adatbevitel. Most feltételezzük, hogy nincs.
- Magas Leverage h és magas Mahalanobis D2: 95-ös válasz
Ez a válasz a prediktortérben outliernek számít. Vizsgáljuk meg, hogy mekkora a maradványértéke. Mivel kiexportáltuk a standardizált maradványértékeket, megkeressük az adattáblában, és azt látjuk, hogy -0.9906667365. Ez nagyon alacsony.
Ha nem lett volna alacsony, akkor ez egy kritikus befolyásoló pont (Critical Influential Case) lenne. Ez esetben ellenőriznénk a DFBETA értékét is.
- Cook-féle távolság: 29-es és 128-as válasz esete
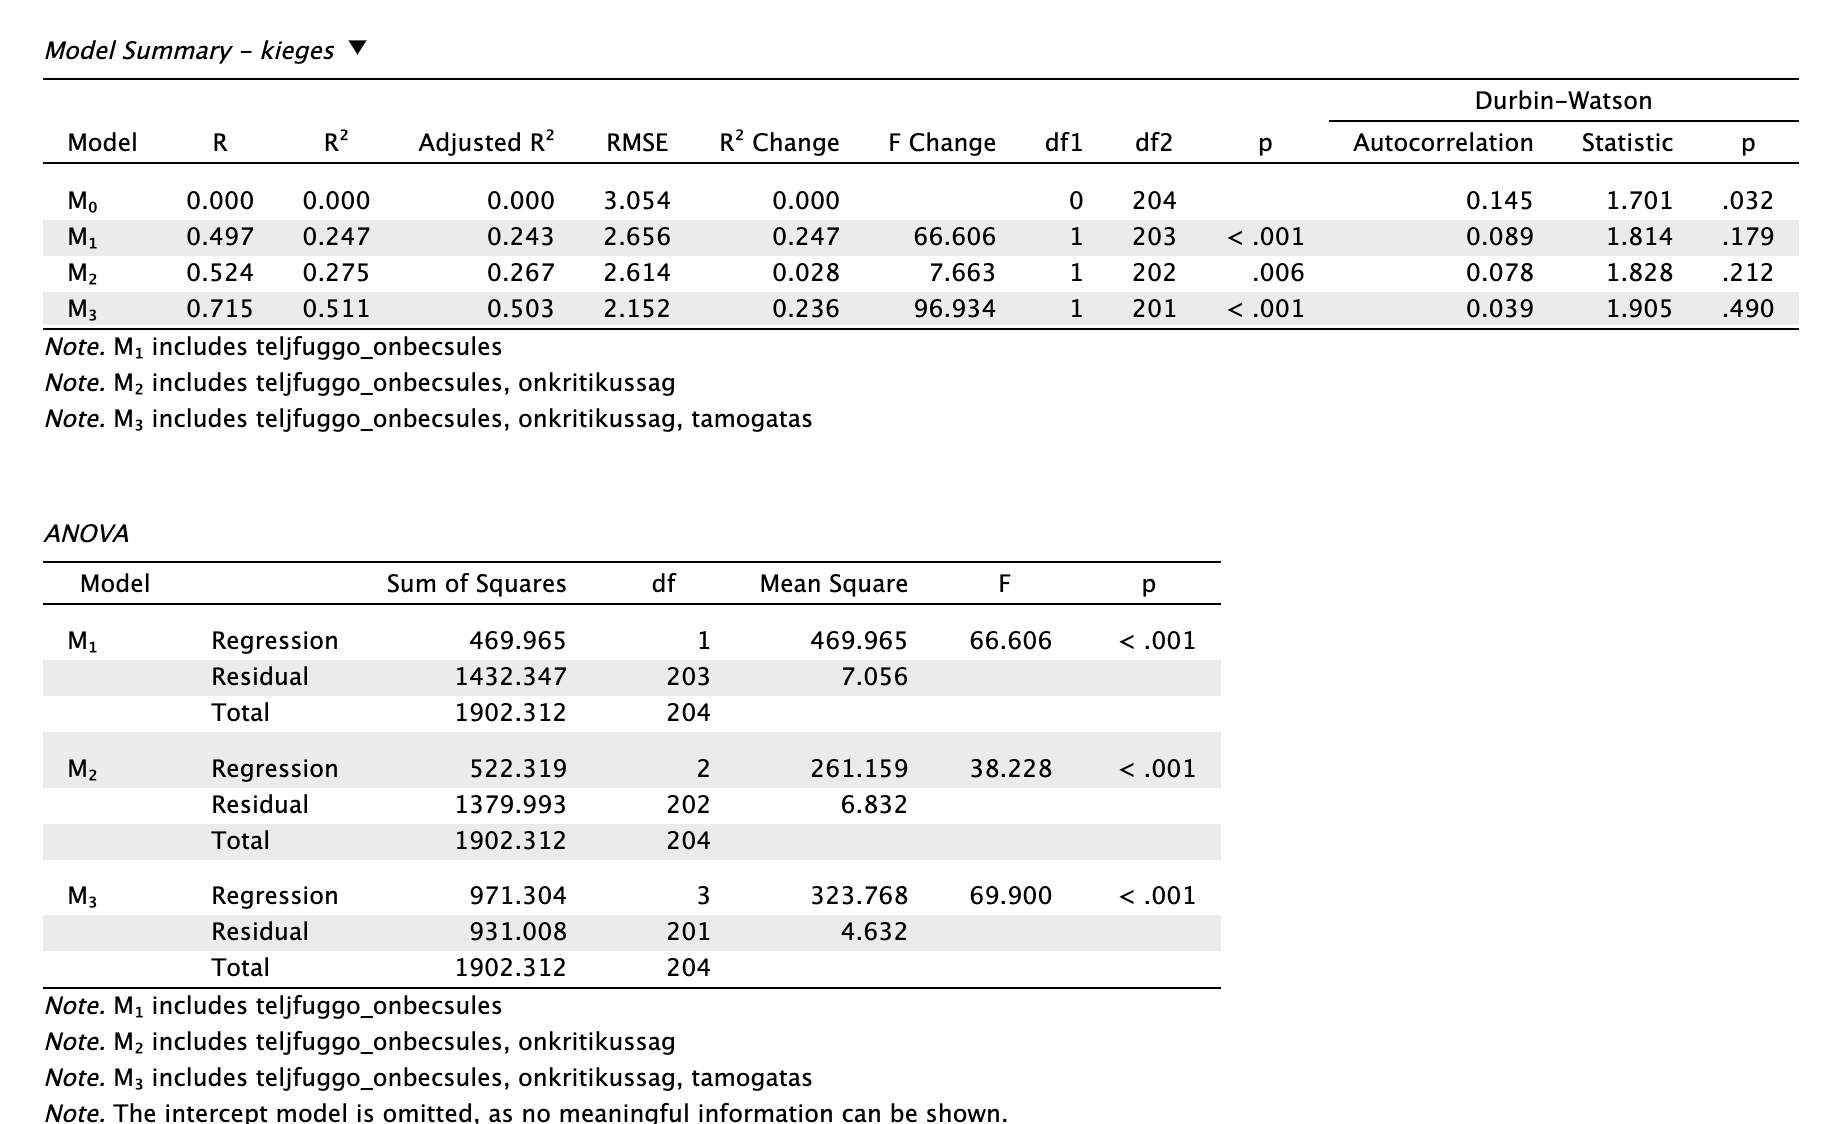
Mivel minden érték a skálák elméleti minimum- és maximumértékén belül helyezkedik el, valós, extrém válaszadókról van szó. A modellt lefuttattuk a teljes mintán, de megnézzük, hogy milyenek lennének a modellünk mutatói, ha a 29-es és 128-as tételt exkludálnánk. (Nem töröljük, kiszűrjük.)
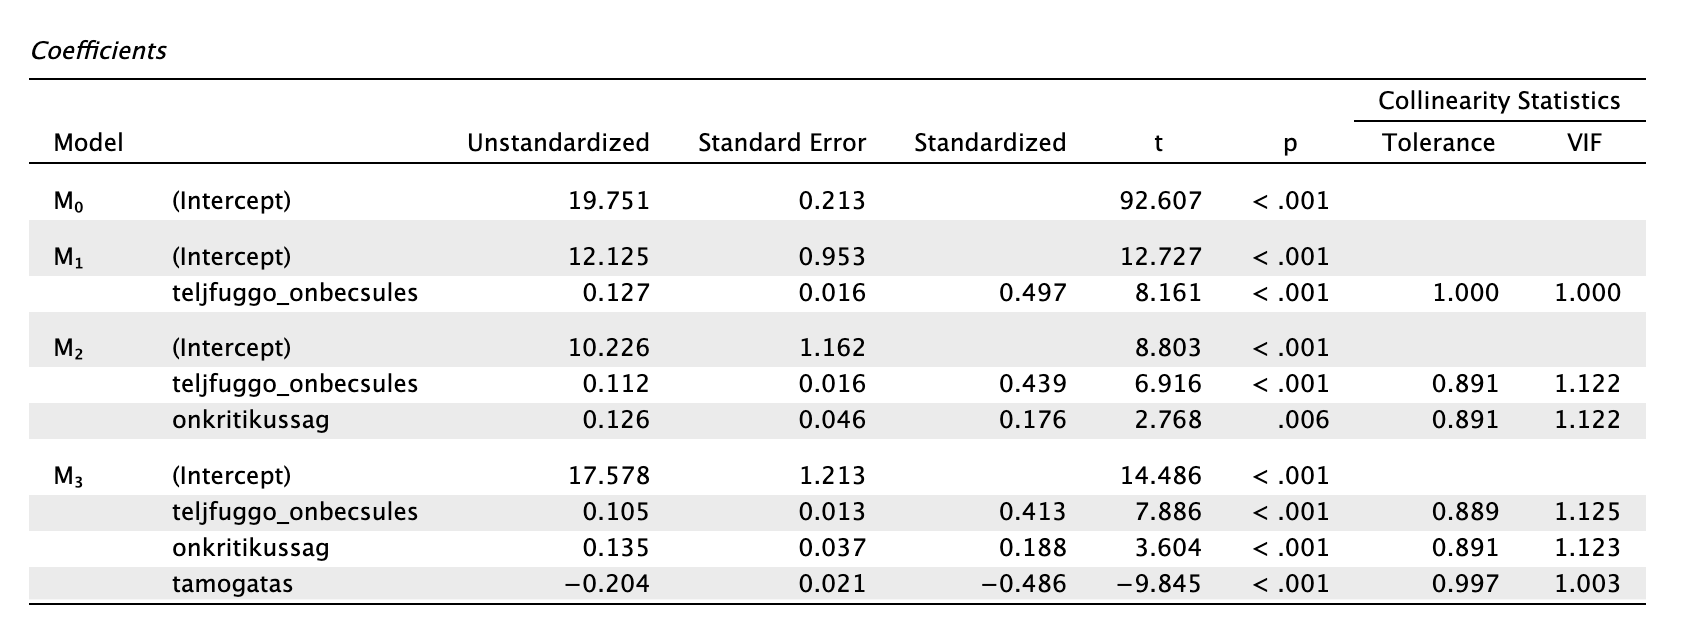
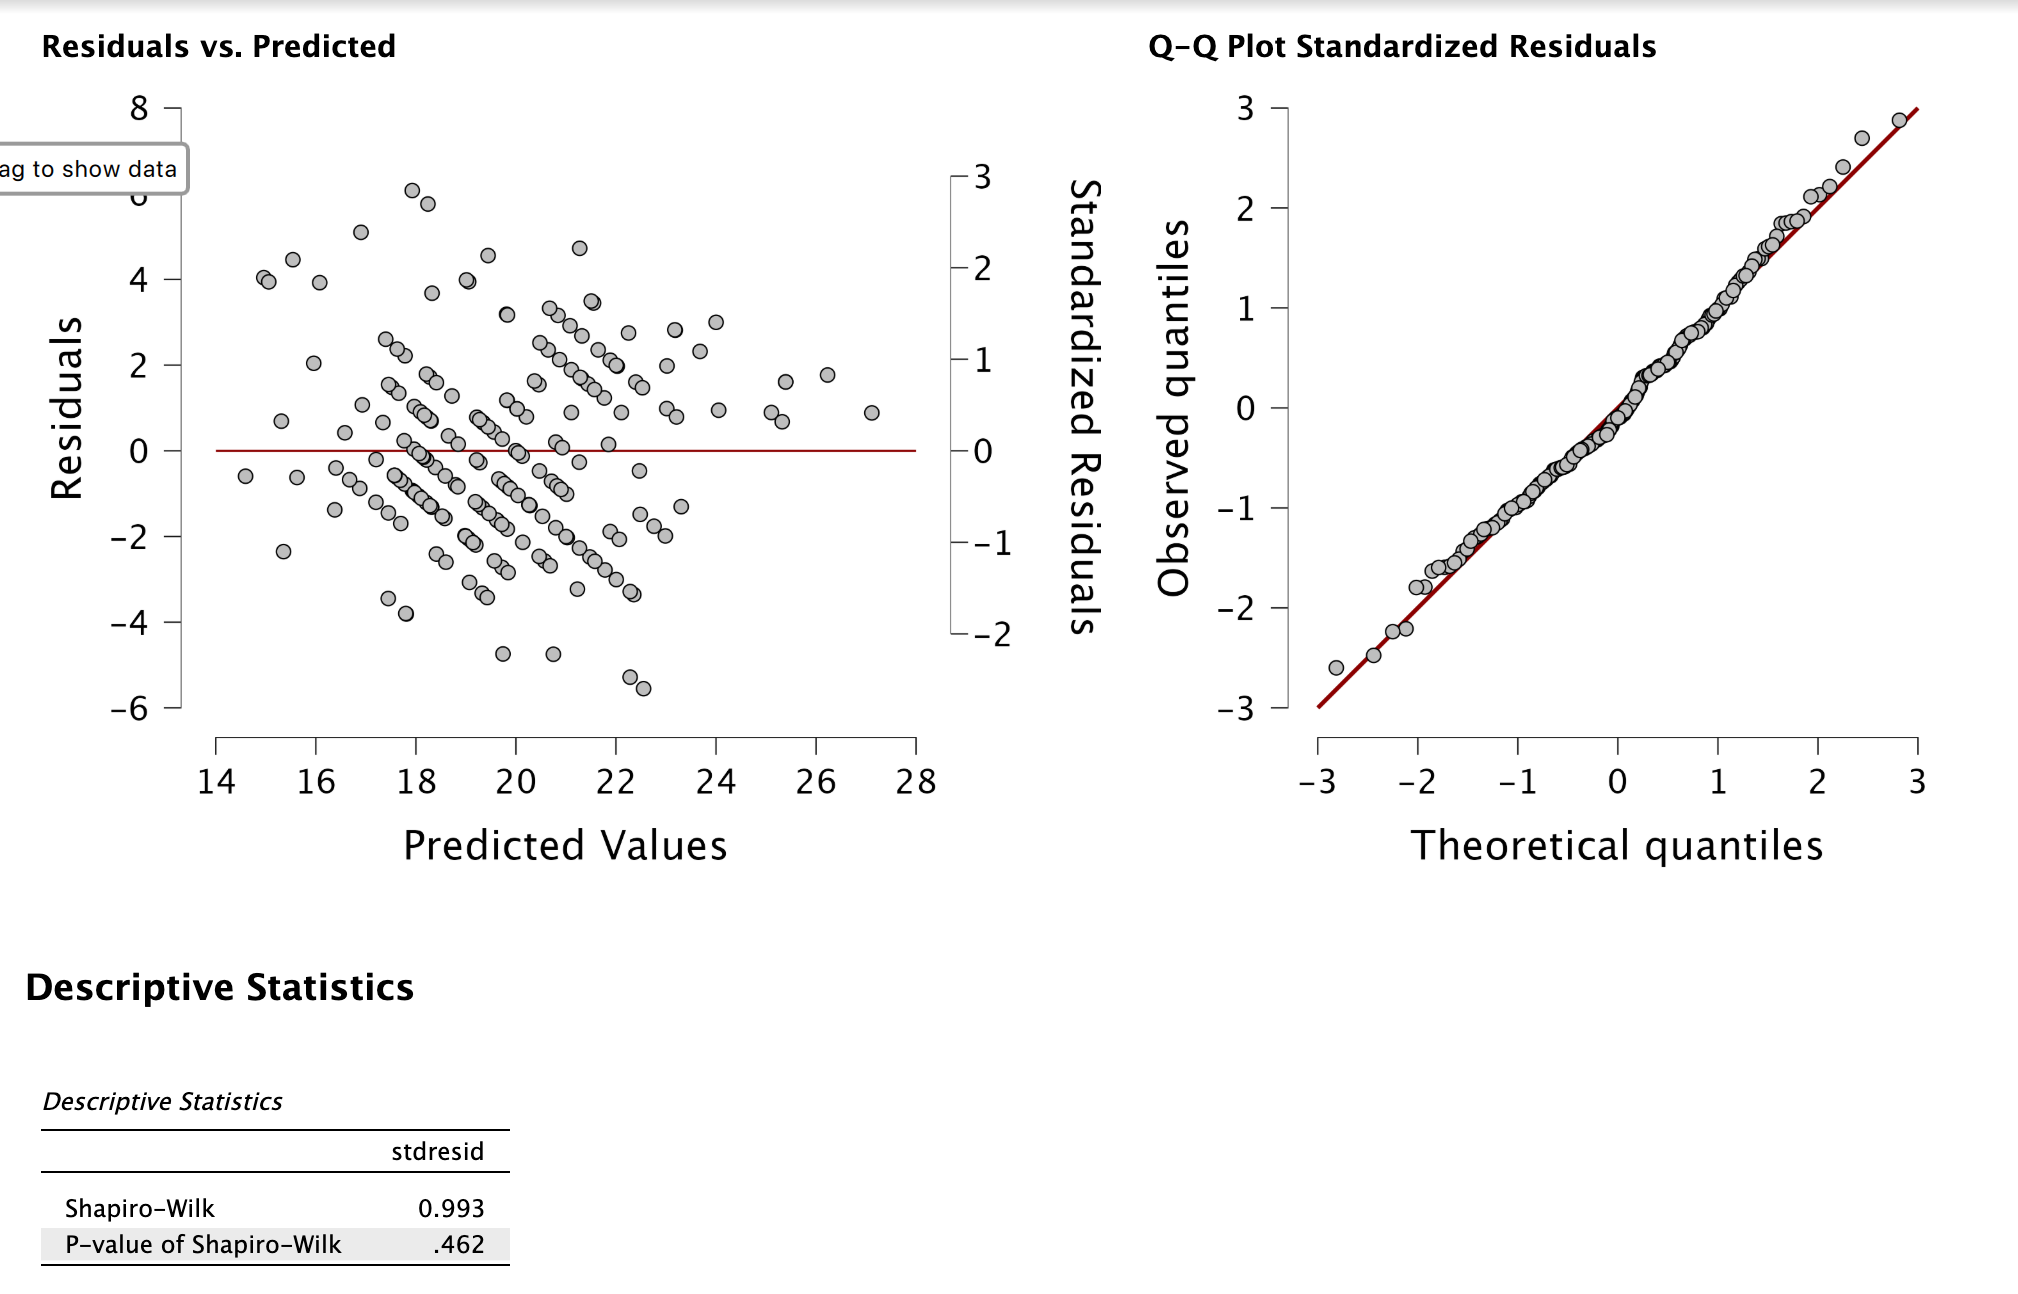
Kiszűrve azt látjuk, hogy a modellünk magyarázóereje (R2 és F) jelentősen emelkedett, és minden predikor szignifikáns maradt, standardizált bétájuk is nőtt. Ráadásul a maradványértékek normalitása is rendeződött.
KÖVETKEZTETÉS:
Mivel a prediktorok iránya és szignifikanciaszintje nem változott meg, levonhatjuk a következtetést, hogy az eredeti modellünk robusztus és stabil, nem csupán 2 extrém kitöltő terméke.
Megoldás 7.1. A kiégés prediktorait hierarchikus lineáris regressziós modellel vizsgáltunk felnőtt mintán (N = 207). A prediktorok modellbe vonásának sorrendjét szakirodalmi megfontolások alapján határoztuk meg.
Az első modellben (M1) a teljesítményfüggő önbecsülés szignifikáns regressziós modellt eredményezett, F(1, 205) = 58,54, p < 0,001, és a kiégés varianciájának 22,2%-át magyarázta (R2 = 0,222, korrigált R2 = 0,218). A teljesítményfüggő önbecsülés szignifikáns pozitív kapcsolatot mutatott a kiégéssel (B = 0,124, SE = 0,016 , β = 0,471, t(205) = 7,65, p < 0,001).
A második modellben (M2) az önkritikusság bevonása szignifikáns magyarázóerő-növekményt eredményezett, ΔR2 = 0,027, ΔF(1, 204) = 7,34, p = 0,007. A modell továbbra is szignifikáns maradt, F(2, 204) = 33,84, p < 0,001, R2 = 0,249, korrigált R2 = 0,242. Az önkritikusság önmagában is szignifikáns pozitív prediktornak bizonyult (B = 0,129, SE = 0,047, β; = 0,174, t(204) = 2,71,p = 0,007), miközben a teljesítményfüggő önbecsülés hatása enyhén mérséklődött (β; = 0,413, p < 0,001).
A harmadik modellben (M3) a szociális támogatás bevonása további 17,9%-kal növelte a megmagyarázott variancia arányát: ΔR2 = 0,179, ΔF(1, 203) = 63,74, p < 0,001. A modell szignifikáns illeszkedést mutatott, F(3, 203) = 50,75, p < 0,001, és a kiégés varianciájának összesen 42,9%-át magyarázta (R2 = 0,429, korrigált R2 = 0,420). A végső modellben a szociális támogatás szignifikáns negatív (protektív) prediktornak bizonyult (B = −0,180, SE = 0,023, β = −0,424, t(203) = −7,98, p < 0,001), míg a teljesítményfüggő önbecsülés (B = 0,102, SE = 0,015, β = 0,389, t(203) = 6,91, p < 0,001) és az önkritikusság (B=0,139,SE = 0,042, β = 0,188, t(203) = 3,33, p = 0,001) továbbra is kiégést pozitívan predikáló tényezők maradtak.
A végső modell feltételvizsgálata során multikollinearitás nem mutatkozott (VIF ≤ 1,13), a maradványértékek függetlenek voltak (Durbin-Watson = 1,992). A homoszkedaszticitás vizuális meggyőződés alapján fennállt. A standardizált maradványértékek Shapiro–Wilk tesztje a maradványértékek normalitásának sérülését jelezte (W = 0,960, p <0,001), amit két extrém maradványértékkel rendelkező eset (29: 4,81, Cook-féle D = 0,101; 128: 3,96, Cook-féle D = 0,132) okozott. A modell robusztusságának ellenőrzésére elvégzett szenzitivitás-elemzés alapján ezen két eset kizárása (N = 205) mellett a végső modell magyarázóereje emelkedett (R2 = 0,511, ΔF(1, 201) = 96,93, p <0,001), és a standardizált maradványértékek normalitása helyreállt (W = 0,993, p = 0,462). Mivel a prediktorok iránya, relatív súlya és szignifikanciaszintje változatlan maradt (teljesítményfüggő önbecsülés: β = 0,413, p < 0,001; önkritikusság: β = 0,188, p < 0,001; szociális támogatás: β = −0,486, p < 0,001), az eredeti, teljes mintás becslés stabilnak és megbízhatónak tekinthető.
X. Táblázat A kiégést előrejelző hierarchikus lineáris regressziós modellek összefoglalása (N = 207)
| Modell és prediktorok | B | SE | β | t | p |
|---|---|---|---|---|---|
| 1. Modell — R2 = 0,222 (korr. R2 = 0,218); F(1, 205) = 58,537, p < 0,001 | |||||
| Konstans | 12,401 | 0,989 | — | 12,534 | < 0,001 |
| Teljesítményfüggő önbecsülés | 0,124 | 0,016 | 0,471 | 7,651 | < 0,001 |
| 2. Modell — R2 = 0,249 (korr. R2 = 0,242); F(2, 204) = 33,843, p < 0,001 | ΔR2 = 0,027; ΔF(1, 204) = 7,339, p = 0,007 | |||||
| Konstans | 10,467 | 1,208 | — | 8,665 | < 0,001 |
| Teljesítményfüggő önbecsülés | 0,109 | 0,017 | 0,413 | 6,426 | < 0,001 |
| Önkritikusság | 0,129 | 0,047 | 0,174 | 2,709 | 0,007 |
| 3. Modell — R2 = 0,429 (korr. R2 = 0,420); F(3, 203) = 50,747, p < 0,001 | ΔR2 = 0,179; ΔF(1, 203) = 63,738, p < 0,001 | |||||
| Konstans | 16,973 | 1,334 | — | 12,722 | < 0,001 |
| Teljesítményfüggő önbecsülés | 0,102 | 0,015 | 0,389 | 6,910 | < 0,001 |
| Önkritikusság | 0,139 | 0,042 | 0,188 | 3,334 | 0,001 |
| Szociális támogatás | -0,180 | 0,023 | -0,424 | -7,984 | < 0,001 |
Megjegyzés. N = 207. B = nem standardizált regressziós együttható; SE = standard hiba; β = standardizált regressziós együttható.