
3 Hipotézisvizsgálat és nevezetes eloszlások
3.1 A hipotézis
A hipotézis egy populációra vonatkozó állítás vagy feltételezés, aminek a tesztelésére bizonyítékot (adatot) gyűjtünk, amit statisztikai próbával (hipotézisvizsgáló eljárás) elemzünk.
A hipotézisünket nem igazoljuk, hanem a felvett, mért adatokon teszteljük a hihetőségét.
Minden hipotézisvizsgálat során két kijelentést teszünk:
Nullhipotézis (H0): ennek a visszautasításáról döntünk (ti. visszautasítjuk vagy nem)
Alternatív hipotézis (H1): a nullhipotézissel egymást kölcsönösen kizáró állítás.
A hipotézisvizsgálat során egész pontosan azt vizsgáljuk, hogy mennyi a valószínűsége annak, hogy a kapott adatokkal megegyező vagy azoknál szélsőségesebb eredményeket kapunk, ha a nullhipotézist igaznak vesszük. Ezt adja meg nekünk a próba p-értéke (Wasserstein és Lazar, 2016).
Ha például azt vizsgáljuk, hogy a klinikánkon a kliensek depressziószintje azonos-e a szomszéd klinika klienseinek depressziószintjével, akkor az alábbi hipotéziseket állítjuk fel:
- H0: A két minta átlaga egyenlő.
- H1: A két minta átlaga nem egyenlő.
Az alternatív hipotézés megfogalmazható a fenti módon (kétoldalú próbához), ahol szimplán tagadjuk a nullhipotézist, de megfogalmazhatjuk intervallumra vonatkozóan („nagyobb/kisebb, mint…” formában) is. Ez esetben a statisztikai próbánk során egyoldalú p-értéket kapunk.
Kiválasztjuk ennek tesztelésére a statisztikai eljárást, ami a függetlenmintás t-próba lesz.
3.2 Első- és másodfajú hiba, a statisztikai próbánk ereje
A hipotézisvizsgálat során azonban elkövethetünk hibákat:
Lehet fals pozitív döntésünk, ez az elsőfajú hiba (Type I error).
Előzetesen (a priori) rögzítjük, hogy mennyi esélyt adunk ennek a hibának: ez lesz a statisztikai próbánk szignifikanciaszintje (α). Pszichológiai kutatásokban ezt 5%-on szoktuk rögzíteni, vagyis α = 0,05 kritériumszintet határozunk meg. Ha a próbánk p-értéke ennél nagyobb, akkor a próba statisztikailag nem szignifikáns, tehát nem utasítjuk el a nullhipotézist. Ha a p-érték ennél kisebb, akkor elutasítjuk a nullhipotézist, a próbánk statisztikailag szignifikáns.
Lehet fals negatív döntésünk, ez a másodfajú hiba (Type II error).
Ennek a kritériumszintjét β-val jelöljük. Ezt a kritériumszintet nem tudjuk előre rögzíteni, mert ez a mintaelemszám, a szignifikanciaszint, és egyéb paraméterek (pl. hatásnagyság, elemszám-illesztettség stb.) függvénye. Előzetes (a priori) mintaelemszám-becslés során azonban 1–β vagy β alakban tudjuk megadni, hogy kiszámoljuk, hogy adott statisztikai erőhöz vagy másodfajú hiba mellett milyen mintaelemszámra van szükségünk adott hatásnagyság mellett.
A helyesen meghozott döntések közül az 1–β a statisztikai próbánk ereje: annak a valószínűsége, hogy helyesen elutsítjuk a nullhipotézist, vagyis annak a valószínűsége, hogy detektálunk egy valós hatást.
| Elutasítom a H0-t | Nem utasítom el a H0-t | |
|---|---|---|
| Valójában H0 hamis | helyes döntés (1 – β) a próba ereje | másodfajú hiba: fals negatív (β) |
| Valójában H0 igaz | elsőfajú hiba: fals pozitív (α) | helyes döntés (1 – α) |
Lefordítva a példánkra:
| Elutasítom a H0-t, miszerint a két átlag egyenlő (tehát van különbség) | Nem utasítom el a H0-t, miszerint a két átlag egyenlő (tehát nincs különbség) | |
|---|---|---|
| Valójában van különbség (a H0 hamis) | helyes döntés (1 – β) | másodfajú hiba: fals negatív (β) |
| Valójában nincs különbség (a H0 igaz) | elsőfajú hiba: fals pozitív (α) | helyes döntés (1 – α) |
A következő ábrán alsó görbe mutatja a nullhipotézishez tartozó eloszlást, ahol a két csoport különbsége nulla köré várható.
A felső két görbe mutatja az alternatív hipotézist, miszerint ténylegesen van különbség a két minta között (jelen esetben -20 és 20 a különbség, amit ábrázoltunk).
Ha kétoldali próbát végzünk, akkor az α szignifikanciánkat kettéosztjuk, a kritériumszint (szaggatott vonal) az α/2-höz (narancssárga terület) igazodik. Vagyis annak az esélye, hogy elutasítjuk a nullhipotézist, miközben az igaz.
A statisztikai erőt (1 - β) mutató kékeszöld terület annak a valószínűsége, hogy helyesen elutasítjuk a nullhipotézist, ha az alternatív hipotézis igaz.
A kutatásunk eredménye alapján mi már valójában tudjuk, hogy pozitív vagy negatív a különbség, de ha kétoldalú próbát tesztelünk, akkor annak az ára, hogy kisebb statisztikai erővel dolgozunk.
Ha egyoldalú próbával dolgozunk, akkor az α érték nem oszlik ketté, a próbánk ereje is nagyobb lesz, de a másik irányra nem tudunk tesztelni:

A példánkra lefordítva, a következőképpen néznek ki az összehasonlítandó minták eloszlásai:

Példa 3.1 Tudjuk, hogy a mi klinikánk átlaga (M =) 107, szórása (SD =) 27,11, míg a másik klinika átlaga 120, szórása 27,11. Mindkét minta 30-30 fős. Látjuk tehát, hogy a különbség 13 (a mi klinikánkon alacsonyabb a depresszió).
Azonban a kiválasztott kétoldalú statisztikai próba (kétoldalú függetlenmintás t-próba) során kiszámítunk egy t-értéket, ami 1,8572 lesz. A próbához tartozó szabadságfokunk 58 (60 fő összesen - 2), a különbség standard hibája 7,000. Ezt követően kiszámítjuk, hogy egy 58-as szabadságfokú t-eloszláson az x = -1,8572 és x =-∞ közötti függvény alatti terület mekkora (ez adja meg a p/2 értéket), ami 0,03418, majd az x = 1,8572 és x = +∞ közötti függény alatti területet (a másik oldali p/2 érték), ami szintén 0,03418, majd ezeket összeadva megkapjuk a próbánk p-értékét, ami 0,06836. (Nyilvánvalóan elég az egyiket kiszámítani és megszorozni kettővel). Tehát az az eredményünk, hogy statisztikailag nincs szignifikáns különbség a csoportok átlagai között (ennek oka lehet a magas szórás és kis mintaelemszám, valamint kis különbség), ha 5%-on rögzítettük az α szignifikanciát.
Az alábbi ábrán a +13-as különbséget látjuk ábrázolva SEdiff = 7 érték melett α = 5% szignifikanciaszinten, de kétoldalú próba esetén, tehát oldalanként 2,5-2,5%-os elfogadási tartománnyal. Tehát a H0-hoz tartozó görbén a kritériumszint alatti értéket látunk, vagyis nem utasíthatjuk el a H0-t.

Ha egyoldalú próbát végzünk, akkor a p-értékünk:
- vagy 1-hez közelítve 0,96582 (mert nem abban az irányban van az eltérés)
- vagy 0,03418 lenne, ami már szignifikáns eltérés α = 5% szignifikancia mellett.
Az alábbi ábrán a +13-as különbséget látjuk ábrázolva SEdiff = 7 értékkel α = 5% szignifikanciaszinten. Tehát a H0-hoz tartozó ábrán a kritériumszint fölötti értéket mutatunk, vagyis el kell utasítsuk a H0-t.

A t-próbának egyéb feltételei is vannak, amiket vizsgálnunk kellett volna, ezeket a 9-11 fejezetek tartalmazzák majd. Mindenesetre a statisztikai hipotézisvizsgálatnak ez a módja.
3.3 Normál eloszlás
Tulajdonságai:
- unimodális
- átlag, módusz és medián egybeesik
- szimmetrikus az átlag körül
- ferdeség 0, az elemek 50%-a átlag alatti, másik 50%-a átlag feletti
- csúcsosság (excess kurtosis) 0
- haranggörbe alakú
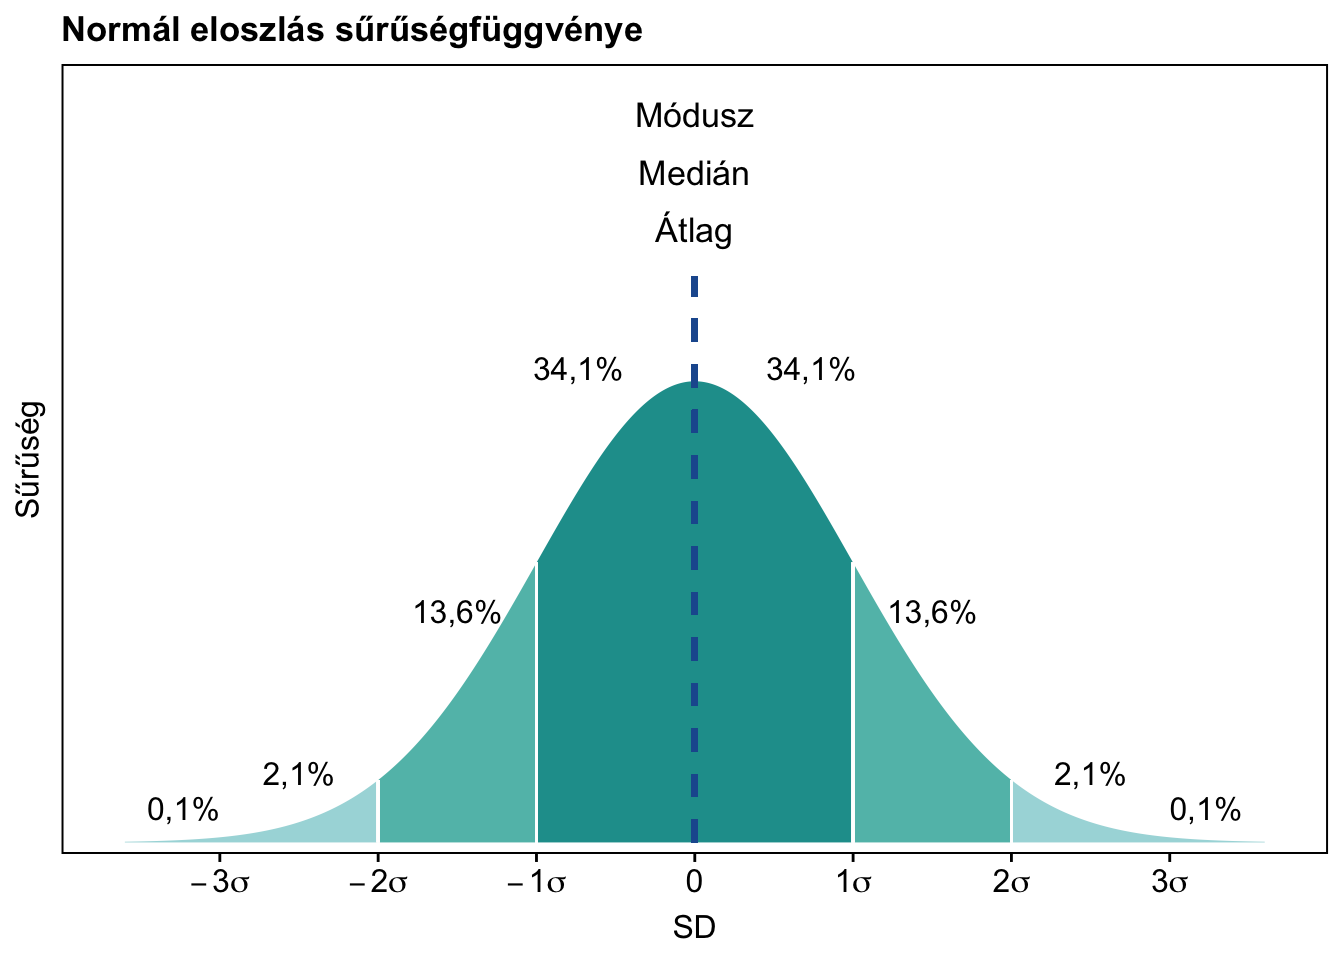
Szórás standardizált egysége a σ szigma.
- -1 és 1 σ tartomány lefedi a minta 68,27%-át
- -2 és 2 σ tartomány lefedi a minta 95,45%-át
- -3 és 3 σ tartomány lefedi a minta 99,73%-át
Valószínűségi jelentése: 68% a valószínűsége, hogy a mintából véletlenszerűen kiválasztott elem a -1 és 1 σ tartományba esik.
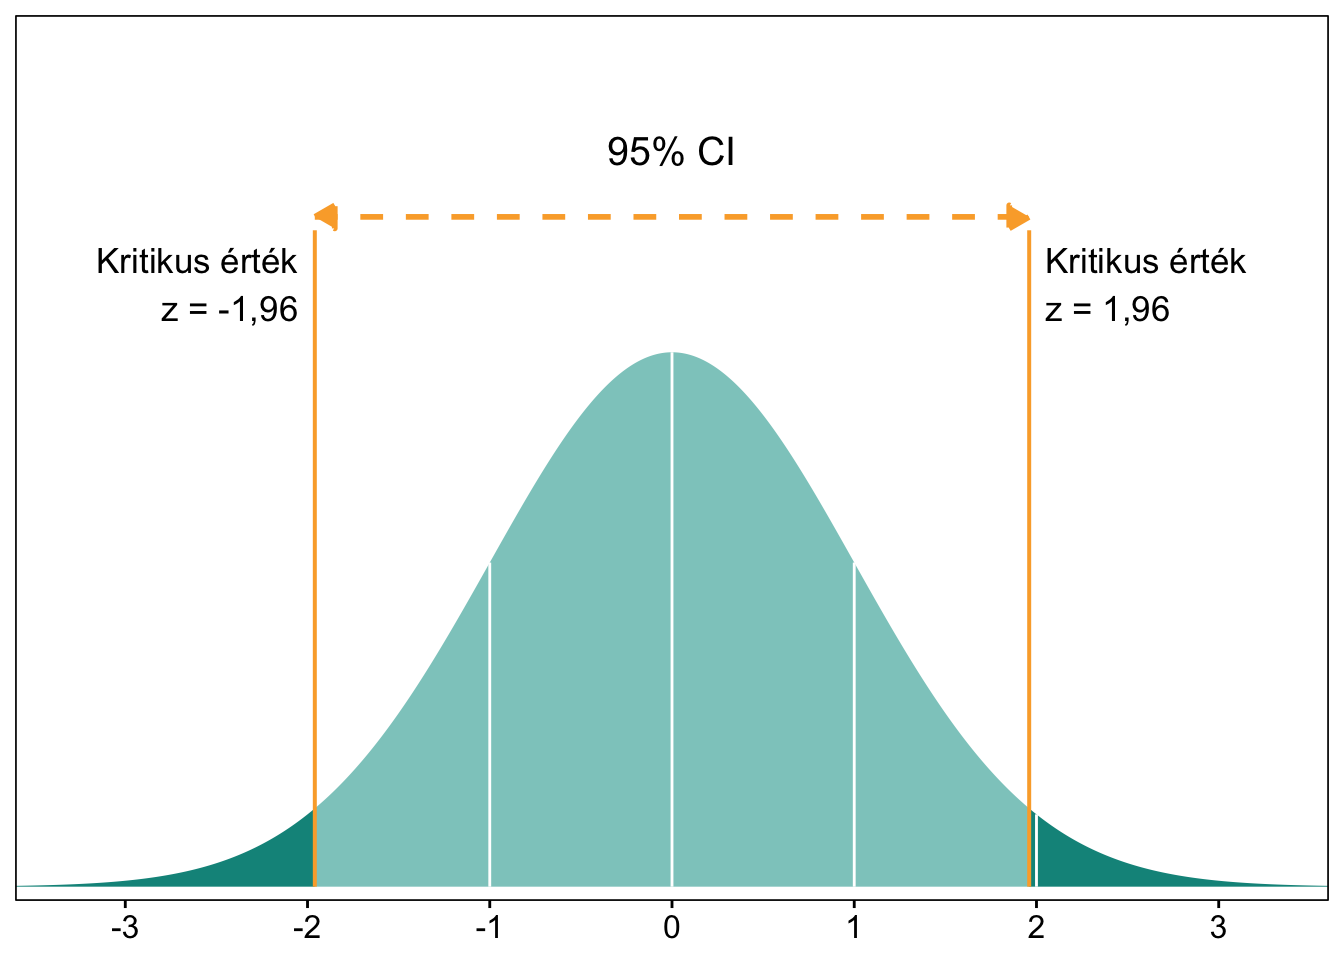
Ez alapján a 95%-os megbízhatósági tartomány (konfidencia-intervallum) -1,96 - 1,96 σ tartománynak felel meg.
3.4 z-eloszlás
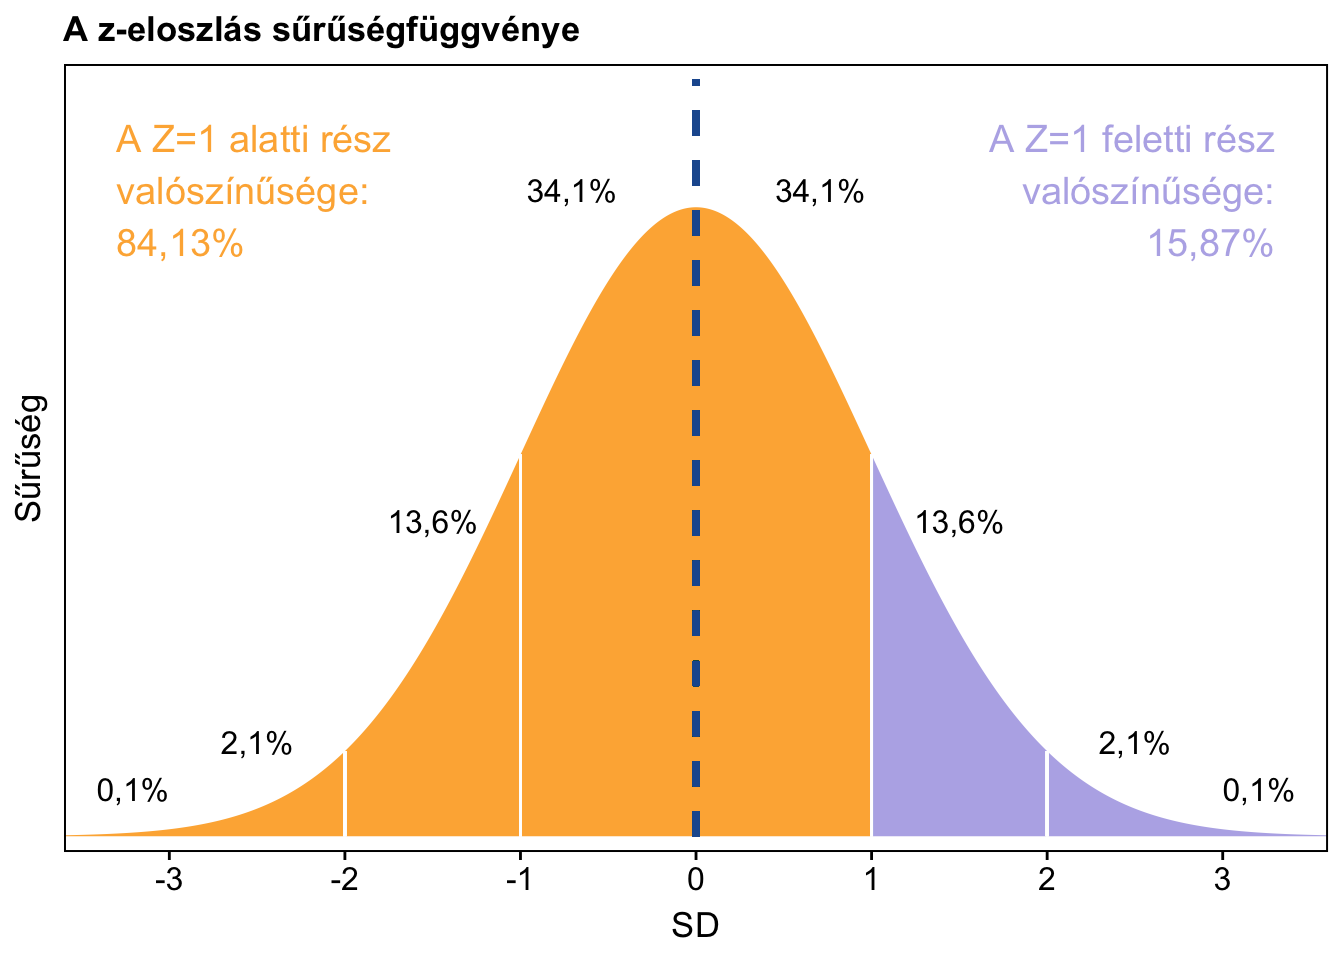
A z-érték egy skálázatlan mérőszám, ami megadja, hogy a nyers pontszám hány szórásnyira van az átlagtól.
\(Z = 0\) az a pont, amely az átlagtól 0 szórásnyira van \(Z = 1\) az a pont, amely az átlagtól 1 szórásnyi távolságra van pozitív irányban \(Z = -2\) az a pont, amely az átlagtól 2 szórásnyi távolságra van negatív irányban
\[ Z = \frac{x-\mu}{\sigma} \]
3.4.1 Standardizálás lineáris z-transzformációval
Átalakíthatjuk a mintánkat, hogy használhatóak legyenek a normál eloszlás valószínűségei olyan formában, hogy a mi mintánk átlaga 0 és a szórása 1 legyen. Ez egy hasznos módszer különféle fokozatú Likert-skála kérdőívek összehasonlításához.
Ahhoz, hogy a minta átlaga 0 legyen, el kell tolnunk a kezdeti eloszlásunkat az x tengely mentén. Ehhez az adathalmaz minden eleméből kivonjuk a kezdeti eloszlásunk átlagát.
Ahhoz pedig, hogy a szórása 1 legyen, a kezdeti adathalmaz minden elemét elosztjuk a szórással.
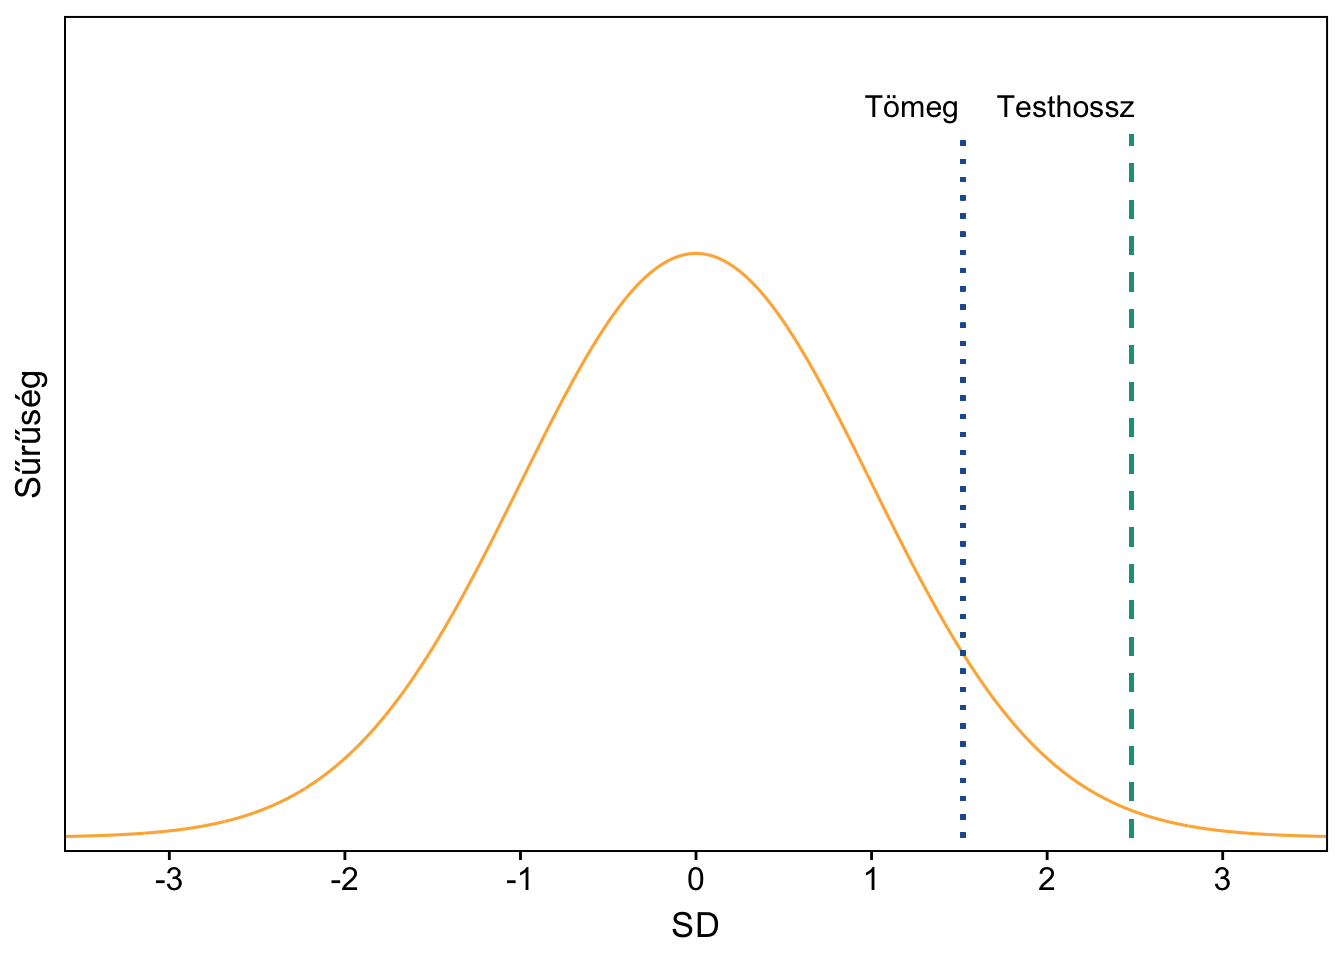
Példa 3.2 (Standardizálás különböző mértékegységű adatok összehasonlíthatóságáért) Ha egy újszülött 56 cm és 4 kg, melyik érték az extrémebb?
Más szakmai dimenziója van a két változónak. Ezért azt tudjuk összevetni, hogy a populáció átlagától hány szórásnyira van.
Feltételezzük, hogy a magyar csecsemők populációjára az alábbi paraméterek igazak:
- Testhossz: M = 49,8 cm (SD = 2,5 cm)
- Tömeg: M = 3,24 kg (SD = 0,5 kg)
Megoldás 3.1. Z-értékek kiszámítása
A különböző mértékegységű dimenziókon elhelyezkedés extremitását Z-transzformációval vizsgáljuk. A képletünk alapján kiszámítjuk a Z-értéket mindkét változóra:
\[ Z_\text{testhossz} = \frac{x-\mu}{\sigma} = \frac{56-49{,}8}{2,5}=2{,}48 \]
\[ Z_\text{tömeg} = \frac{x-\mu}{\sigma} = \frac{4-3{,}24}{0,5}=1{,}52 \]
3.4.2 Konfidencia-intervallum
A konfidenciaintervallum megbízhatósági szintje (pl. 95%) azt jelenti a gyakorlatban, hogy ha 100 alkalommal megismételjük a mintavételt, a populációnk várható értéke (átlaga, μ), amit becsülni próbálunk, az ezen a konfidenciaintervallum-tartományon belül lesz (pl. 95 alkalommal). A fennmaradó (pl. 5) alkalommal elsőfajú hibát (α) vétünk. Ez lesz a szignifikanciaszint fogalma.
Hogyan határozzuk meg a konfidencia-intervallumot?
\[ \text{CI}_{1-\alpha}=\bar{x} \pm z \frac{s}{\sqrt{n}} = \bar{x} \pm z \times \text{SEM} \] Ahol \(\bar{x}\) az áltag, \(z\) a kívánt megbízhatósági szinthez tartozó z-érték, \(s\) a szórás, \(n\) a mintaelemszám. A szórás és a mintaelemszám gyökének hányadosa az átlag standard hibája: \(\text{SEM}\).
Például 95%-os konfidenciaintervallum alsó és felső határa:
\[ \text{CI}_\text{95 alsó határ}=\bar{x} - 1{,}96 \times \text{SEM} \] \[ \text{CI}_\text{95 felső határ}=\bar{x} + 1{,}96 \times \text{SEM} \]
| Konfidencia-intervallum: | 90% | 95% | 99% |
|---|---|---|---|
| Z-érték-tartományok kétoldalú próba esetén | -1,64 - 1,64 | -1,96 - 1,96 | -2,57 - 2,57 |
| α kétoldalú próba esetén | 0,05 | 0,025 | 0,005 |
| Z-érték kritikus érték egyoldalú próba esetén | 1,28 | 1,64 | 1,96 |
| α egyoldalú próba esetén | 0,1 | 0,05 | 0,01 |
Példa 3.3 (Konfidenciaintervallum alkalmazása) Munkapszichológus felmérte, hogy egy cég dolgozói hány órát töltenek hetente szorongással. Az \(n = 38\) válaszadó (ti. minta) átlagosan heti \(\bar{x} = 3{,}9\) órát jelentett önbevallásos módon. Az adatok szórása \(s = 1{,}14\).
95%-os konfidenciaintervallum mellett a cég összes dolgozója (ti. populáció) hány órát szorong átlagosan hetente?
Megoldás 3.2 (Kiszámítás). \[ \text{CI}_{1-\alpha}=\bar{x} \pm z \frac{s}{\sqrt{n}} = \bar{x} \pm z \times \text{SEM} \]
Az átlagos és szórást ismerjük, az átlag standard hibáját a szórás és mintaelemszám értékeiből ki tudjuk számítani. A 95%-hoz tartozó z-értéket ismerjük (a fenti táblázatból): 1,96.
\[ \text{CI}_\text{95 alsó határ}=\bar{x} - 1{,}96 \times \frac{s}{\sqrt{n}} = 3{,}9 - 1{,}96 \times \frac{1{,}14}{\sqrt{38}} \approx 3,54 \]
\[ \text{CI}_\text{95 felső határ}=\bar{x} + 1{,}96 \times \frac{s}{\sqrt{n}} = 3{,}9 + 1{,}96 \times \frac{1{,}14}{\sqrt{38}} \approx 4,26 \]
95%-os konfidenciaintervallum mellett a cég összes dolgozója átlagosan várhatóan 3,5–4,3 órát szorong hetente.
3.5 Student-féle t-eloszlás
A z-eloszláshoz ismertük a populáció átlagát és a szórását is. A t-eloszlást akkor használjuk, amikor az átlagot ugyan ismerjük, de a szórást nem, és feltételezhetjük, hogy a populáció normál eloszlást követ.
Ez az eloszlás lesz a t-próba alapja.
\[ t = \frac{\bar{x} - \mu}{\frac{s}{\sqrt{n}}} \] Ahol \(\bar{x}\) a mintaátlag, \(\mu\) a populációátlag, a nevező pedig a mintaátlag standard hibája.
A t-eloszlás jellemzője a szabadságfoka. Minél nagyobb a t-eloszlás szabadságfoka, annál inkább hasonlít a normál eloszlásra.
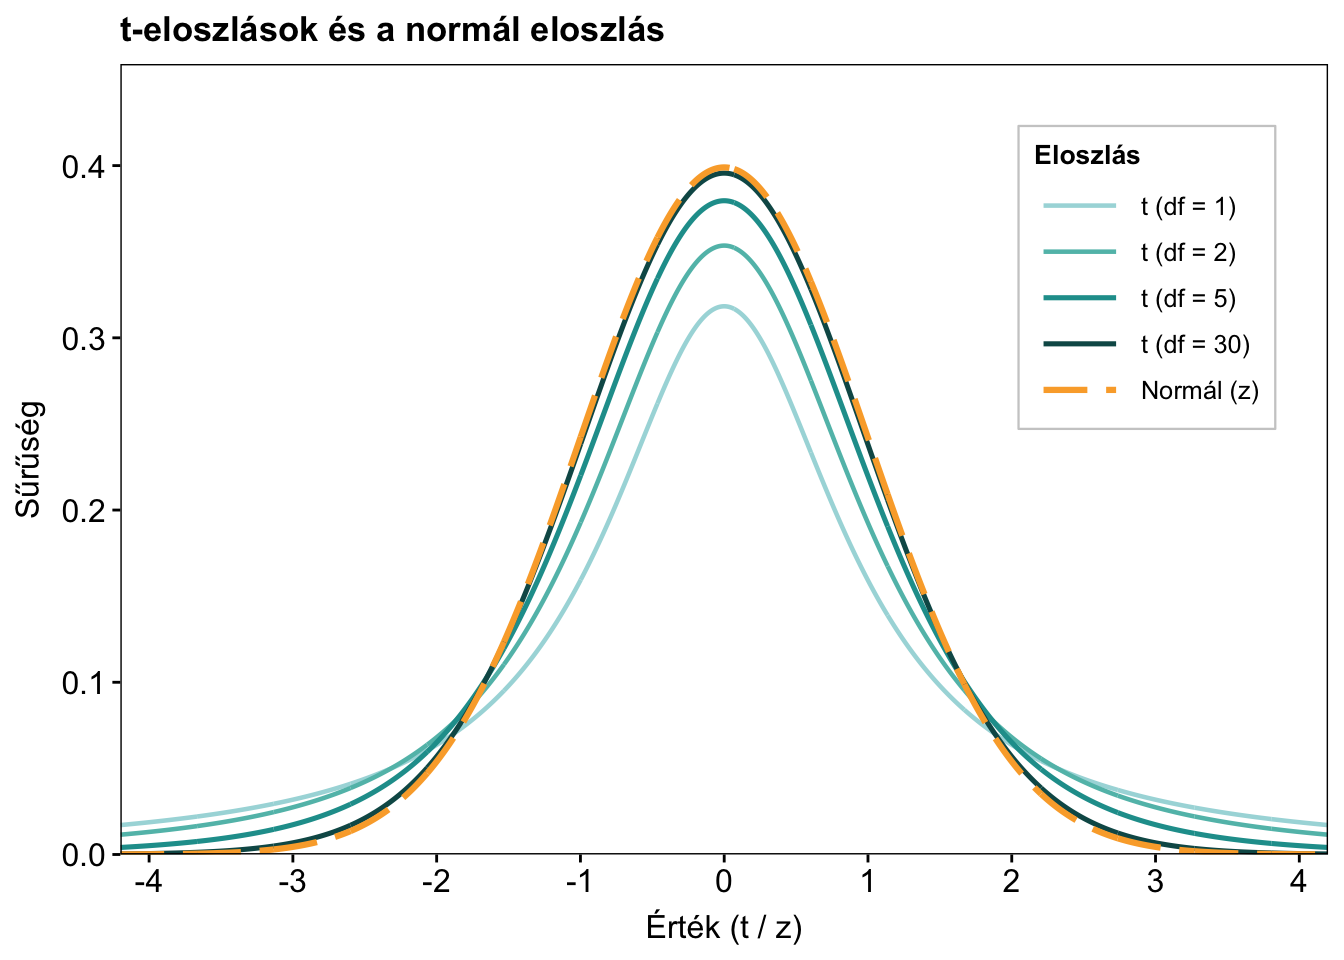
Példa 3.4 (Szorongás) Van egy (n =) 56 fős klinikai mintánk, ahol a Beck Szorongás Leltárra kapott összpontszámok átlaga (M =) 26,31 pont, szórása (SD =) 9,26. A súlyos szorongásként megjelölt kategóriához tartozó pontszám 36 a kérdőív standardjai alapján. Mennyi a valószínűsége, hogy egy páciensünk erőteljes, súlyos szorongást él át (36 pont vagy afölötti összpontszáma legyen)?
Megoldás 3.3 (Megoldás). Kiszámoljuk a 36 ponthoz tartozó t-értéket, és megnézzük, hogy milyen jobboldali valószínűség tartozik hozzá.
\[ t_i = \frac{x_i - \bar{x}}{s} \]
A becslés szabadságfoka \(df = n - 1 = 56 -1 = 55\).
\[ t_i = \frac{x_i - \bar{x}}{s} = \frac{36 - 26{,}31}{9{,}26} = 1{,}046436 \]
Megkeressük az 1,046436 értékhez tartozó valószínűséget (a függvény alatti területet). Ezt t-eloszlás táblázattal, vagy R-rel tesszük. De valójában ilyet nekünk kézzel sosem kell majd számolgatni.
\[ 1- P(1,046436) = 1- 0,85003 = 0,14997 \approx 15\% \]
A minta alapján annak a valószínűsége, hogy egy klinikai páciensünk 36 vagy magasabb pontot ér el a BAI kérdőíven 15%, feltételezve, hogy a mintánk jól reprezentálja a klinikai populációt, és a szorongás a populációban normál eloszlást követ.
3.6 χ2-eloszlás
k számú, egymástól független normál eloszlású valószínűségi változó négyzetösszege χ2-eloszlást fog követni.
Az eloszlást szabadságfok (df) paraméter jellemzi, ami az összeadott négyzetes normáleloszlások száma (df = k).
- Csak nemnegatív tartományban értelmezhető
- Unimodális
- Átlag megegyezik a szabadságfokkal
- Nem szimmetrikus
- Ferdeség (skewness) > 0
- Csúcsosság (kurtosis) > 0 (leptokurtikus)
\[ \chi^2 = \sum^k_{i=1}{\frac{(O_i-E_i)^2}{E_i}} \]
Ahol \(O_i\) a mért érték, \(E_i\) a várható érték.
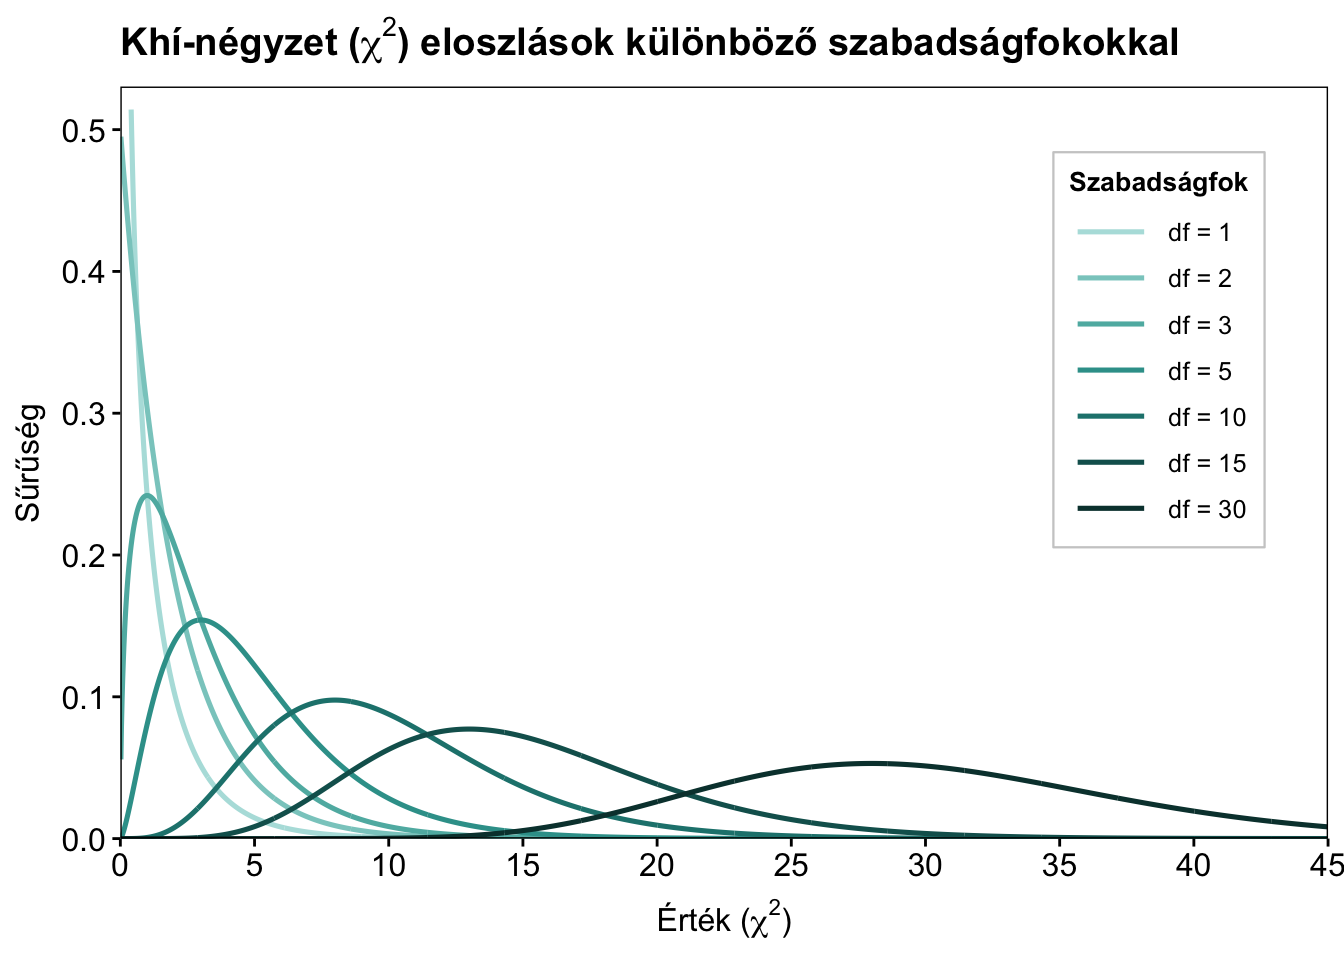
A khínégyzet-eloszlásokat fogjuk használni illeszkedés-, függetlenség-, és homogenitásvizsgálatnál többek között. Ezeket a vonatkozó fejezetben tárgyaljuk majd.
3.7 F-eloszlás
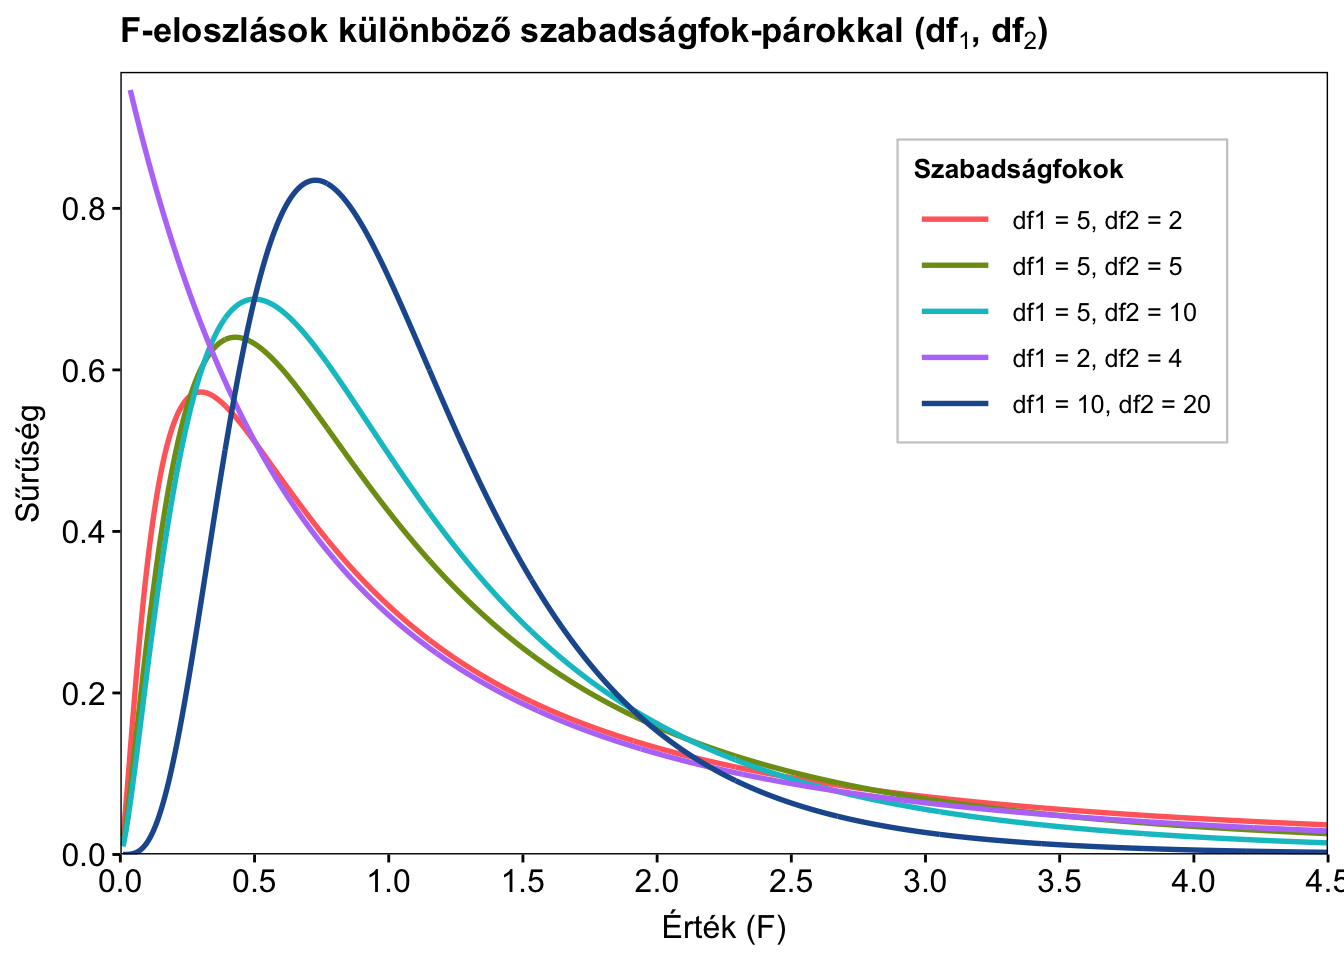
Az F-eloszlás valójában két adott szabadságfokú khínégyzet-eloszlás aránya. Varianciák arányainak számításakor használjuk.
Két szabadságfok paraméter jellemzi:
- \(df_1\) a \(Q_1\) \(\chi^2\)-eloszlás szabadságfoka
- \(df_2\) a \(Q_2\) \(\chi^2\)-eloszlás szabadságfoka
- Ugyanúgy csak nemnegatív tartományban értelmezhető
- Unimodális
- Átlaga \(\frac{df_2}{\frac{df_2}{2}}\), ha \(df_2 > 2\)
- Nem szimmetrikus
- Ferdeség (skewness) > 0
- Csúcsosság (kurtosis) > 0 (leptokurtikus)
\[ F=\frac{\frac{Q_1}{df_1}}{\frac{Q_2}{df_2}} \]
3.8 Egyéb eloszlások
Több egyéb eloszlásról (pl. binomiális, Poisson-féle, béta-eloszlás) érdemes matematika tankönyveket olvasni. Ezeket itt nem tárgyaljuk.